اجرای هوش مصنوعی روی PS5 با یک پروژه غیررسمی وارد مرحله تازهای شده است. نسخه PS5LM Plus میتواند مدلهای زبانی را روی پردازنده گرافیکی کنسول جیلبریکشده اجرا کند. به گزارش تامز هاردور در ۱۶ اکتبر ۲۰۲۶، این تغییر امکان استفاده از مدلهای بزرگتر را فراهم کرده است. سرعت حدود ۱۲۴ توکنبرثانیه به مدل کوچک Llama 3.2 3B مربوط است؛ مدل ۲۷ میلیاردپارامتری Qwen حدود ۲۰ توکنبرثانیه تولید میکند.
درباره تصویر اصلی: نمای PS5 با دو دسته روی پسزمینه آبی، با هوش مصنوعی برای این مقاله تولید شده است؛ تصویر کنسول مورد استفاده در آزمایش نیست.
هوش مصنوعی روی PS5 چگونه اجرا شده است؟
PS5LM Plus از پروژه PS5LM ساخته Mert Cobanov منشعب شده و ابزار متنباز llama.cpp را به کنسول آورده است. توسعهدهنده با نام AdIllustrious7246 در ردیت میگوید نسخه اولیه بهصورت برنامهای موسوم به payload روی CPU اجرا میشد و حدود ۶ گیبیبایت حافظه در اختیار داشت. نسخه بومی او با استفاده از Vulkan و درایور RADV در پروژه PS5_Vulkan به GPU دسترسی پیدا میکند.
طبق گزارش اولیه توسعهدهنده، حافظه قابل استفاده برنامه به حدود ۱۱٫۴ گیبیبایت رسیده است. این تغییر، تخصیص حافظه بیشتر به برنامه را نشان میدهد؛ حافظه فیزیکی تازهای به کنسول اضافه نشده است.
کدام مدل با چه سرعتی اجرا میشود؟
جدول زیر نتایج اعلامشده در مخزن PS5LM Plus است. این اعداد بنچمارک مستقل استوکلند نیستند و به نسخه کمحجمشده مدل، تنظیمات حافظه و طول ورودی وابستهاند.
| مدل و نسخه آزمایششده | سرعت تولید گزارششده |
|---|---|
| Llama 3.2 3B Instruct — Q4_K_M | حدود ۱۲۴ توکن در ثانیه |
| Gemma 4 E4B — QAT q4_0 | حدود ۶۱ توکن در ثانیه |
| Qwen 3.8 27B — UD-IQ2_XXS | حدود ۲۰٫۷ توکن در ثانیه |
توکن، واحد پردازش متن در مدل زبانی است و لزوماً با یک کلمه برابر نیست. بنابراین ۱۲۴ توکنبرثانیه را نباید ۱۲۴ کلمهبرثانیه خواند. همچنین عدد سرعت، کیفیت پاسخ یا دقت مدل را بهتنهایی مشخص نمیکند.
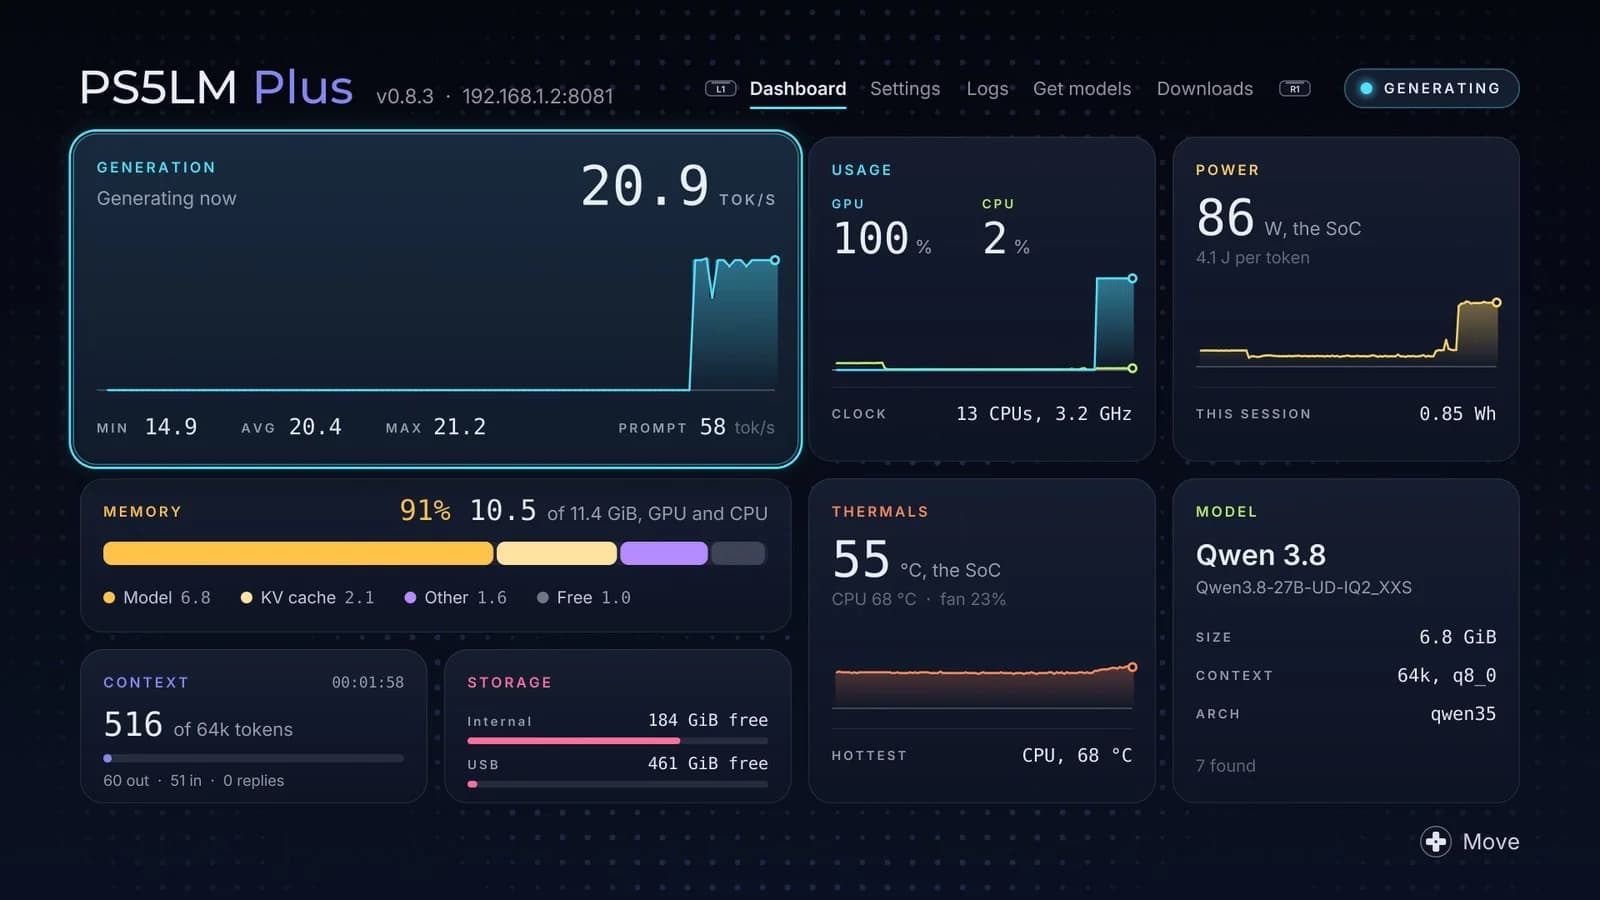
منبع تصویر داشبورد: فایل اصلی در مخزن PS5LM Plus، بدون تغییر محتوایی؛ مخزن تحت مجوز GPL-3.0-or-later منتشر شده است.
از کنسول تا گفتوگو در مرورگر
طبق مستندات پروژه، داشبورد روی تلویزیون سرعت تولید متن، استفاده از CPU و GPU، دما و تقسیم حافظه میان مدل و کش را نشان میدهد. رابط وب llama.cpp نیز اجازه میدهد از یک گوشی یا رایانه در شبکه محلی با مدل گفتوگو کنید. پردازش مدل روی کنسول انجام میشود.
- کتابخانه مدلها فایلهای GGUF را از حافظه داخلی، USB یا درایو M.2 شناسایی میکند.
- ابزار دریافت مدل، امکان مرور مخازن Hugging Face و ادامه دانلود قطعشده را دارد.
این قابلیت برای همه دارندگان PS5 آماده است؟
خیر. پروژه به PS5 جیلبریکشده و محیط اجرای برنامههای غیررسمی نیاز دارد و قابلیت رسمی عرضهشده توسط سونی نیست. وجود یک اجرای موفق، سازگاری با تمام نسخههای نرمافزار سیستم یا تمام مدلهای زبانی را ثابت نمیکند.
برداشت تحریریه استوکلند: ارزش این پروژه در نشاندادن کاربرد تازه سختافزار کنسول است. برای ارزیابی آن بهعنوان رایانه هوش مصنوعی، سرعت تنها یکی از معیارهاست؛ کیفیت خروجی، پایداری اجرای طولانی و محدودیت حافظه نیز اهمیت دارند. بدون آزمایش همشرایط نمیتوان نتیجه گرفت PS5 جایگزین بهتری برای یک رایانه شخصی است.
برای آشنایی با تفاوت نسخههای سختافزاری کنسول، بررسی مدلها و ویژگیهای پلیاستیشن ۵ در استوکلند را بخوانید.
پرسشهای رایج
آیا مدل ۲۷ میلیاردپارامتری هم با ۱۲۴ توکن در ثانیه اجرا شده است؟
خیر. سرعت حدود ۱۲۴ توکن در ثانیه برای Llama 3.2 3B گزارش شده است. نسخه کمحجمشده Qwen 3.8 27B در آزمایش توسعهدهنده حدود ۲۰ توکن در ثانیه تولید میکند.
آیا اجرای این مدلها به سرویس ابری نیاز دارد؟
استنتاج مدل بهصورت محلی روی کنسول انجام میشود. پس از آمادهسازی فایلهای لازم، برای تولید پاسخ نیازی به سرویس پردازش ابری نیست؛ دریافت مدلها میتواند به اینترنت نیاز داشته باشد.

اولین دیدگاه مفید درباره این مطلب را شما بنویسید.