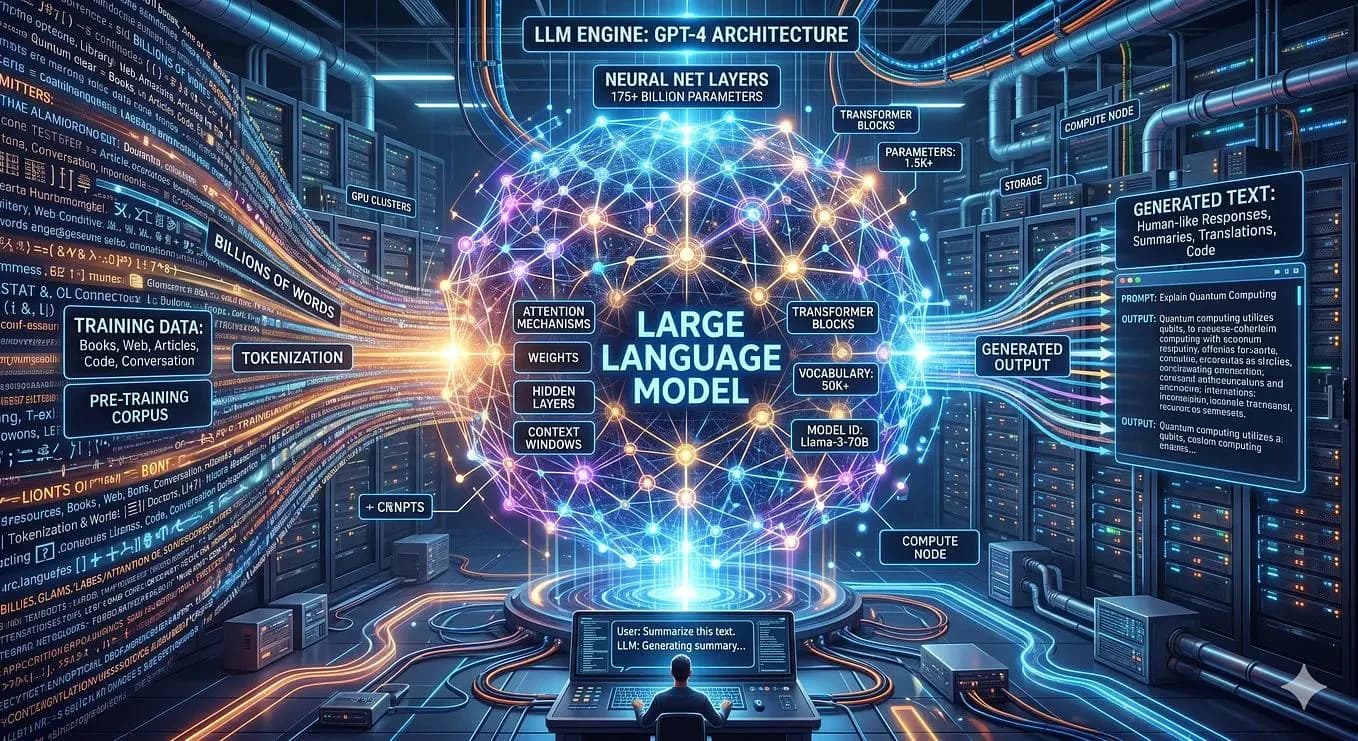
مدل زبانی بزرگ (LLM) یکی از فناوریهای اصلی هوش مصنوعی مولد است که به ماشین امکان میدهد الگوهای زبان را پردازش کند و بر اساس آنها متن تولید کند. این مدلها با استفاده از روشهای یادگیری ماشین و یادگیری عمیق آموزش میبینند و در کارهایی مانند پاسخگویی به پرسشها، تحلیل متن و تولید کد کاربرد دارند. اما برای شناخت واقعی LLM، نباید فقط به پاسخهای جذاب و گاهی غافلگیرکنندهاش بسنده کرد. این مدلها چطور آموزش میبینند، چگونه پاسخ میسازند و چه عواملی تعیین میکنند که خروجیشان دقیق باشد یا با اعتمادبهنفس، مسیر اشتباهی را بروند؟
اما شناخت این فناوری بدون بررسی محدودیتهایش کامل نیست. چرا مدلهای زبانی گاهی پاسخ نادرست تولید میکنند؟ تفاوت LLM با ChatGPT و هوش مصنوعی مولد چیست؟ مدلهای زبانی بزرگ فارسی تا چه اندازه در پردازش متن فارسی توانمندند؟ و اگر بخواهید یک مدل را روی کامپیوتر شخصی خود اجرا کنید، واقعا به چه سختافزاری نیاز دارید؟ در ادامه، این پرسشها را با تکیه بر مستندات فنی و منابع معتبر بررسی میکنیم تا در استوکلند، تصویری روشن از قابلیتها، محدودیتها و کاربردهای واقعی مدلهای زبانی بزرگ به دست بیاورید؛ چون شناخت فناوری، خیلی بهتر از اعتماد کردن به اسمهای پرزرقوبرق آن است!
مدل زبانی بزرگ (LLM) چیست؟
مدل زبانی بزرگ (LLM) نوعی مدل هوش مصنوعی مبتنی بر یادگیری عمیق است. این مدل با آموزش روی حجم عظیمی از دادههای متنی، الگوهای زبان را یاد میگیرد. سپس میتواند متن تولید کند، به پرسشها پاسخ دهد و در برنامهنویسی کمک کند. بسیاری از مدلهای زبانی بزرگ امروزی بر پایه معماری ترنسفورمر (Transformer) ساخته شدهاند. این معماری به مدل کمک میکند ارتباط میان بخشهای مختلف متن را بررسی کند.
این مدل ابتدا متن ورودی را به واحدهای کوچکتری به نام توکن (Token) تقسیم میکند. سپس با توجه به زمینه و الگوهایی که در مرحله آموزش آموخته است، توکن بعدی را پیشبینی میکند. این فرایند بارها تکرار میشود تا پاسخ شکل بگیرد. بنابراین، LLMها مانند انسان درک آگاهانه ندارند؛ آنها از الگوهای آموختهشده برای تولید پاسخ استفاده میکنند. همین سازوکار یکی از دلایلی است که پاسخ مدل میتواند روان و متقاعدکننده باشد، اما همچنان حاوی اطلاعات نادرست یا توهم هوش مصنوعی (AI Hallucination) باشد.
مدل زبانی بزرگ (LLM) چگونه کار میکند؟
مدل زبانی بزرگ (LLM) ابتدا متن ورودی را با فرایند توکنسازی (Tokenization) به واحدهای کوچکی به نام توکن (Token) تقسیم میکند. سپس شبکه عصبی مدل، این توکنها را به شکل بازنماییهای عددی پردازش میکند و ارتباط میان بخشهای متن را میسنجد. بر اساس الگوهایی که طی آموزش یاد گرفته است، مدل احتمال توکن بعدی را محاسبه میکند. این فرایند بارها تکرار میشود تا پاسخ شکل بگیرد.
در بسیاری از مدلهای زبانی بزرگ، معماری ترنسفورمر (Transformer) نقش مهمی در پردازش متن دارد. یکی از اجزای کلیدی آن، سازوکار خودتوجهی (Self-Attention) است که به مدل کمک میکند ارتباط میان توکنها را در بافت جمله بررسی کند. واژههای اطراف به مدل کمک میکنند کاربرد درست این کلمه را در هر عبارت تشخیص دهد.
برای انجام این محاسبات، مدل از بازنماییهای عددی توکنها (Embedding) استفاده میکند. این بازنماییها در کنار سازوکار توجه و سایر لایههای شبکه عصبی، به مدل امکان میدهند اطلاعات متن را پردازش کند. معماری ترنسفورمر مزیت دیگری هم دارد: در مرحله آموزش، بسیاری از محاسبات مربوط به توکنهای ورودی را میتوان بهصورت موازی انجام داد. این ویژگی در آموزش مدلهای زبانی بزرگ نقش مهمی داشته است.
هنگام استفاده از مدل، این فرایند استنتاج (Inference) نام دارد. مدل با توجه به ورودی و پارامترهایی که در مرحله آموزش یاد گرفته است، توکن بعدی را پیشبینی و انتخاب میکند. سپس توکن تازه به متن قبلی اضافه میشود و مبنای پیشبینی بعدی قرار میگیرد. البته انتخاب توکن به روش تولید متن بستگی دارد و همیشه به معنای انتخاب محتملترین گزینه نیست.
مدل زبانی بزرگ (LLM) چگونه آموزش داده میشود؟
آموزش مدل زبانی بزرگ (LLM) فرایندی چندمرحلهای است که به مدل کمک میکند الگوهای زبان را یاد بگیرد، ارتباط میان واژهها و مفاهیم را تشخیص دهد و پاسخهای متناسب با ورودی کاربر تولید کند. این فرایند معمولا با آموزش اولیه روی مجموعه بزرگی از دادههای متنی آغاز میشود و در بسیاری از مدلها، با آموزشهای تکمیلی برای بهبود کیفیت پاسخها ادامه پیدا میکند.
پیشآموزش (Pre-training) در مدلهای زبانی بزرگ چیست؟
پیشآموزش (Pre-training) مرحلهای است که در آن مدل زبانی بزرگ (LLM) یاد میگیرد زبان چطور کار میکند. مدل با حجم زیادی از دادههای متنی آموزش میبیند تا الگوهای زبانی، ارتباط میان توکنها و بعضی از روابط معنایی را تشخیص دهد. در بسیاری از مدلهای زبانی مولد، این یادگیری از یک تمرین بهظاهر ساده شروع میشود: پیشبینی توکن بعدی.
برای مثال، جمله «امروز هوا خیلی ...» را در نظر بگیرید. احتمالا «سرد» و «گرم» جزو ادامههای محتملاند؛ اما مدل قرار نیست شانسی یکی را انتخاب کند! با توجه به بافت جمله و الگوهایی که از دادههای آموزشی یاد گرفته، احتمال ادامههای مختلف را محاسبه میکند. هرچه متن بیشتری در اختیار داشته باشد، فرصت بیشتری برای یادگیری الگوهای پیچیدهتر زبان پیدا میکند؛ البته حجم داده بهتنهایی تضمینکننده کیفیت مدل نیست.
اما مدل از کجا میفهمد پیشبینیاش چقدر دقیق بوده است؟ در طول آموزش، توکنی که مدل پیشبینی کرده با توکن واقعی در متن آموزشی مقایسه میشود. اختلاف این دو، مبنای محاسبه خطاست و الگوریتم بهینهسازی با استفاده از این خطا، پارامترهای مدل را بهروزرسانی میکند. این چرخه بارها و بارها روی نمونههای فراوان تکرار میشود تا مدل در پیشبینی توکنها عملکرد بهتری پیدا کند.
البته همه مدلهای زبانی بزرگ از همین روش استفاده نمیکنند. برای نمونه، مدلهای خودرگرسیو مانند بسیاری از مدلهای خانواده GPT معمولا توکن بعدی را پیشبینی میکنند؛ اما مدلهایی مانند BERT در پیشآموزش از روشهایی مثل پیشبینی توکنهای پنهانشده در متن استفاده میکنند.
نکته مهم این است که پیشآموزش صرفا حفظکردن متنهای اینترنت نیست. هدف، یادگیری الگوهایی است که مدل بتواند برای پیشبینی متن و انجام وظایف زبانی از آنها استفاده کند. هرچند مدلها ممکن است بخشهایی از دادههای آموزشی را هم حفظ کنند. پیشآموزش (Pre-training) در مدلهای زبانی بزرگ پایه تواناییهای مدل را میسازد.
چرا آموزش LLM به توان محاسباتی زیادی نیاز دارد؟
آموزش یک مدل زبانی بزرگ (LLM) از صفر، به توان پردازشی، حافظه و دادههای آموزشی زیادی نیاز دارد. هرچه مدل بزرگتر باشد و با توکنهای بیشتری آموزش ببیند، معمولا محاسبات بیشتری لازم است. طول دنبالههای متنی، روش آموزش و سختافزار نیز بر زمان و هزینه اثر میگذارند. به همین دلیل، آموزش مدلهای پیشرفته معمولا به زیرساختهای محاسباتی تخصصی نیاز دارد و روی یک لپتاپ معمولی بهسادگی انجام نمیشود.
هنگام آموزش مدل، حافظه موردنیاز فقط به حجم فایل مدل محدود نیست؛ زیرا محاسبات مربوط به وزنهای شبکه، گرادیانها و وضعیت بهینهساز نیز میتوانند حافظه قابلتوجهی مصرف کنند. البته میزان حافظه و توان پردازشی موردنیاز به اندازه مدل، روش آموزش و تنظیمات اجرا بستگی دارد.
تنظیم دقیق (Fine-tuning) چگونه عملکرد LLM را بهبود میدهد؟
تنظیم دقیق (Fine-tuning) فرایند آموزش بیشتر یک مدل ازپیشآموزشدیده با دادههای هدفمند است تا عملکرد آن برای یک وظیفه یا حوزه مشخص بهبود پیدا کند. برخلاف آموزش از ابتدا، در این مرحله مدل از وزنهایی استفاده میکند که طی پیشآموزش یاد گرفته است؛ بنابراین، تنظیم دقیق معمولا به داده و منابع محاسباتی کمتری از آموزش کامل مدل از ابتدا نیاز دارد.
برای مثال، میتوان یک مدل زبانی را با نمونههای باکیفیت پرسشوپاسخ فنی تنظیم دقیق کرد تا در پاسخگویی به پرسشهای تخصصی، ساختارمندتر و متناسبتر عمل کند. نتیجه به کیفیت دادهها، روش تنظیم دقیق و نحوه ارزیابی مدل بستگی دارد؛ بنابراین این فرایند لزوما همه خطاها را برطرف نمیکند یا صحت پاسخها را تضمین نمیکند.
در برخی روشها، مانند LoRA (Low-Rank Adaptation)، لازم نیست تمام پارامترهای مدل اصلی بهروزرسانی شوند. این روش با محدود کردن پارامترهای قابلآموزش میتواند نیاز به حافظه و توان پردازشی را کاهش دهد؛ هرچند میزان صرفهجویی به مدل و تنظیمات آموزش بستگی دارد.
معماری مدل زبانی بزرگ (LLM) چگونه است؟
معماری مدل زبانی بزرگ (LLM) مشخص میکند شبکه عصبی از چه بخشهایی تشکیل شده و این بخشها چطور با همکاری هم زبان را پردازش میکنند. بیشتر مدلهای زبانی بزرگ امروزی از معماری ترنسفورمر (Transformer) استفاده میکنند؛ اما ترنسفورمر فقط اسکلت اصلی ماجراست! هر مدل از چندین بلوک تشکیل میشود که هرکدام وظیفه مشخصی در پردازش اطلاعات دارند.
بلوکهای ترنسفورمر؛ موتور اصلی LLM: در بسیاری از مدلهای مبتنی بر ترنسفورمر، چندین بلوک پشتسرهم قرار میگیرند. هر بلوک معمولا دو بخش اصلی دارد: لایه خودتوجهی (Self-Attention) و شبکه پیشخور (Feed-Forward Network). خودتوجهی به مدل کمک میکند ارتباط میان توکنها را تشخیص دهد؛ شبکه پیشخور هم اطلاعات هر توکن را بیشتر پردازش میکند. در کنار این دو بخش، اتصال باقیمانده (Residual Connection) و نرمالسازی لایهای (Layer Normalization) به جریان اطلاعات و پایداری آموزش کمک میکنند. به زبان ساده، این بلوکها کمک میکنند مدل کلمات را جدا از هم نبیند و ارتباطشان را در متن تشخیص دهد.
چه چیزی یک مدل را واقعا بزرگ میکند؟ تعداد بلوکها، ابعاد لایهها و تعداد پارامترها در اندازه مدل نقش دارند. برای مثال، مدلی با ۷۰ بلوک و ابعاد پنهان ۸۱۹۲، در شرایط قابلمقایسه میتواند پارامترهای بسیار بیشتری از مدلی با ۱۲ بلوک و ابعاد پنهان ۷۶۸ داشته باشد. البته بزرگتر بودن همیشه به معنی باهوشتر بودن نیست! کیفیت دادههای آموزشی، روش آموزش و نحوه تنظیم مدل هم روی عملکرد نهایی اثر میگذارند.
انواع معماری مدلهای زبانی بزرگ
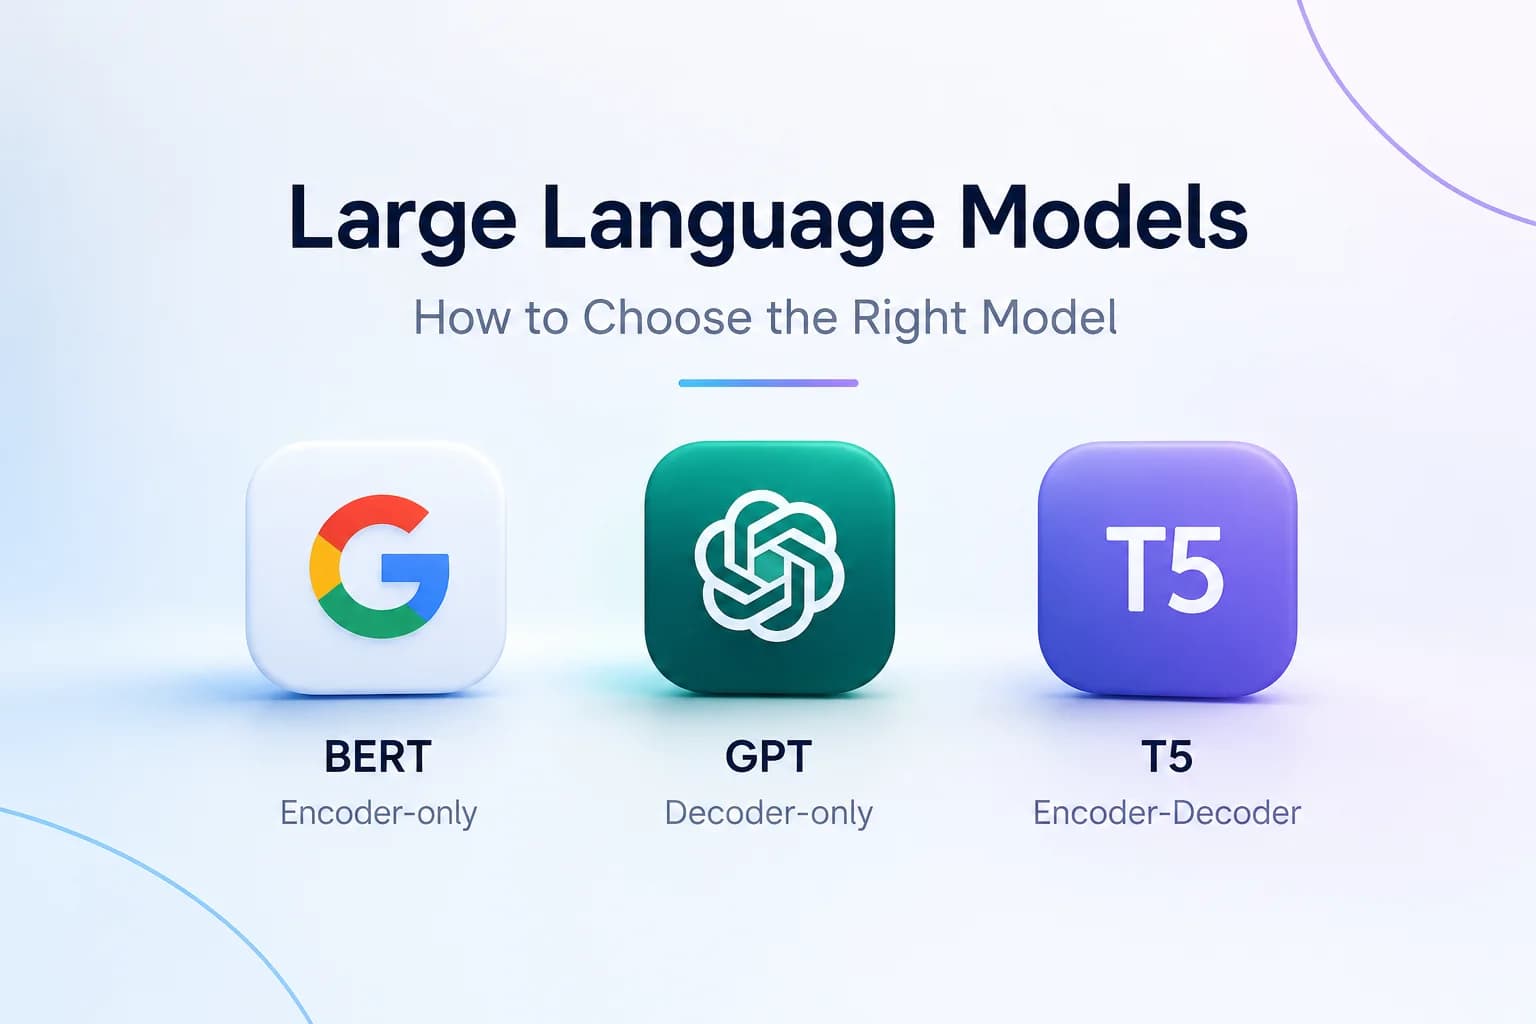
مدل زبانی بزرگ یا LLM (Large Language Model) یکی از فناوریهای مهم هوش مصنوعی مولد است. LLM با روشهای یادگیری عمیق آموزش میبیند تا زبان را پردازش کند و بر اساس الگوهای آموختهشده، متن تولید کند. اما همه مدلهای زبانی بزرگ یک کار را انجام نمیدهند. بعضی در تحلیل متن تخصص دارند، بعضی برای تولید پاسخ و کد مناسباند و برخی هم برای تبدیل یک متن به متنی دیگر طراحی شدهاند. برای شناخت انواع مدلهای زبانی بزرگ، باید هم معماری مدل و هم کاربرد آن را در نظر بگیریم.
مدلهای رمزگذار (Encoder-only)
مدلهای رمزگذار بیشتر روی تحلیل متن ورودی و استخراج اطلاعات از آن تمرکز دارند. از این مدلها میتوان برای دستهبندی متن، تحلیل احساسات و شناسایی نام افراد، مکانها یا سازمانها استفاده کرد. خانواده BERT نمونه شناختهشدهای از این معماری است. از بین انواع مدلهای زبانی بزرگ (LLM)، مدلهای رمزگذار بیشتر دنبال کشف ارتباطهای داخل متن هستند تا اینکه لزوما یک پاسخ بلند تولید کنند.
مدلهای رمزگشا (Decoder-only)
بسیاری از مدلهای زبانی مولد امروزی از معماری رمزگشا استفاده میکنند. این مدلها معمولا با پیشبینی توکن بعدی، متن را مرحلهبهمرحله میسازند و در کارهایی مانند پاسخگویی به پرسشها، نگارش محتوا و برنامهنویسی کاربرد دارند. خانوادههای GPT و Llama از نمونههای شناختهشده این گروهاند. به همین دلیل، وقتی از یک مدل هوش مصنوعی میخواهید متنی بنویسد یا کدی تولید کند، احتمال زیادی دارد با معماری رمزگشا سروکار داشته باشید.
مدلهای رمزگذار–رمزگشا (Encoder–Decoder)
در بین انواع مدلهای زبانی بزرگ (LLM)، مدلهای رمزگذار–رمزگشا برای وظایفی مناسباند که در آنها متن ورودی باید پردازش و به خروجی متنی دیگری تبدیل شود. رمزگذار اطلاعات ورودی را پردازش میکند و رمزگشا با استفاده از این اطلاعات، خروجی را میسازد. ترجمه ماشینی و برخی روشهای خلاصهسازی و بازنویسی از کاربردهای این معماری هستند. مدلهای T5 و BART نیز نمونههایی شناختهشده از این گروهاند. در اینجا هدف فقط ادامه دادن جمله نیست؛ مدل باید خروجی متناسب با وظیفه را تولید کند.
معروفترین مدلهای زبانی بزرگ (LLM)
از GPT و Claude گرفته تا Gemini، Llama، Mistral، DeepSeek و Qwen، خانوادههای مختلفی از مدلهای زبانی بزرگ برای تولید محتوا، تحلیل اطلاعات، برنامهنویسی و کارهای تخصصی توسعه یافتهاند. بعضی از آنها از طریق سرویسهای آنلاین و API در دسترساند و برخی نسخهها نیز وزنهای قابلدریافت دارند که امکان اجرای محلی یا سفارشیسازی را فراهم میکنند.
اما کدام یک معروفترین مدلهای زبانی بزرگ (LLM) بزرگ بهتر است؟ پاسخ به کاری بستگی دارد که میخواهید انجام دهید. کیفیت پاسخ، توانایی استدلال، سرعت، هزینه، پشتیبانی از ورودیهای چندرسانهای و امکان اجرای محلی، همگی در انتخاب مدل نقش دارند. بهترین انتخاب لزوما معروفترین یا بزرگترین مدل نیست؛ مهم این است که با نیاز شما جور دربیاید.
ChatGPT؛ چتبات مبتنی بر LLM شرکت OpenAI
GPT خانوادهای از مدلهای هوش مصنوعی است که در تولید و تحلیل متن، پاسخگویی به پرسشها، برنامهنویسی و حل مسائل پیچیده کاربرد دارد. تواناییها، سرعت و هزینه استفاده از نسخههای مختلف این خانواده یکسان نیست؛ بنابراین، انتخاب مدل باید با توجه به نوع وظیفه و سطح توانایی موردنیاز انجام شود.
Claude؛ مدل زبانی بزرگ Anthropic
Claude خانوادهای از مدلهای زبانی بزرگ (LLM) است که در نگارش، خلاصهسازی، تحلیل اسناد، برنامهنویسی و انجام وظایف پیچیده کاربرد دارد. نسخههای مختلف این مدل هوش مصنوعی، از نظر توانایی، سرعت و هزینه تفاوت دارند و برای همه کارها عملکرد یکسانی ارائه نمیکنند.
برای مثال، تحلیل یک گزارش طولانی یا بررسی کدهای یک پروژه ممکن است به مدلی متفاوت از یک کار ساده مثل دستهبندی متن نیاز داشته باشد. پیش از انتخاب Claude، نوع وظیفه، پیچیدگی آن و محدودیتهای هزینه و زمان را مشخص کنید. به این ترتیب سراغ مدلی نمیروید که برای نیاز شما بیش از حد قدرتمند یا پرهزینه است.
Gemini؛ خانواده مدلهای چندوجهی Google DeepMind
Gemini خانوادهای از مدلهای هوش مصنوعی گوگل است که بسته به نسخه، قابلیت پردازش متن و ورودیهایی مانند تصویر یا صوت را دارد. این تواناییها آن را برای برخی وظایف چندرسانهای مناسب میکنند؛ البته همه نسخهها امکانات یکسانی ندارند. اگر میخواهید مدلهای زبانی بزرگ را با هم مقایسه کنید، مشخصات فنی نسخه موردنظر را بررسی کنید؛ نام یک خانواده بهتنهایی تمام قابلیتهای آن را مشخص نمیکند.
اگر قصد مقایسه Gemini با سایر مدلهای زبانی بزرگ (LLM) را دارید، مشخصات نسخه موردنظر را بررسی کنید. نام یک خانواده بهتنهایی تمام قابلیتها، محدودیتها و هزینه استفاده از آن را مشخص نمیکند.
Llama؛ مدل زبانی بزرگ با وزن باز Meta
Llama خانوادهای از مدلهای هوش مصنوعی توسعهیافته توسط Meta است که برای تولید متن، برنامهنویسی و ساخت برنامههای مبتنی بر هوش مصنوعی به کار میرود. برخی نسخههای این خانواده با وزنهای قابلدریافت منتشر شدهاند و امکان اجرای محلی یا سفارشیسازی را فراهم میکنند.
این ویژگی برای توسعهدهندگانی مفید است که میخواهند مدل را روی کامپیوتر شخصی یا سرور خود اجرا کنند. بااینحال، امکان اجرا و سرعت پاسخگویی به اندازه مدل، میزان کوانتیزهسازی، حافظه و توان پردازشی سختافزار بستگی دارد. شرایط مجوز هر نسخه را نیز بررسی کنید؛ وزنهای قابلدریافت لزوما به معنای استفاده بدون محدودیت نیستند.
Mistral؛ مدل زبانی بزرگ وزن باز فرانسوی Mistral AI
Mistral AI خانوادههای مختلفی از مدلهای زبانی بزرگ (LLM) را برای کاربردهای عمومی و تخصصی ارائه میکند. بسته به نسخه، میتوان از طریق API به مدل دسترسی داشت یا از مدلهایی با وزنهای قابلدریافت استفاده کرد. اندازه مدل، سرعت پاسخگویی، هزینه اجرا و شرایط مجوز از معیارهای مهم انتخاب هستند. در نتیجه، بزرگترین مدل همیشه بهترین گزینه نیست؛ گاهی مدلی کوچکتر و کمهزینهتر، نیاز پروژه را بهتر برطرف میکند.
در انتخاب مدلهای Mistral، فقط به اندازه یا شهرت آنها توجه نکنید. کیفیت خروجی، سرعت پاسخگویی، هزینه اجرا و سازگاری با سختافزار نیز اهمیت دارند. گاهی یک مدل کوچکتر و کمهزینهتر، نیاز پروژه را بهتر برطرف میکند؛ لازم نیست برای هر کار سادهای سراغ سنگینترین گزینه بروید.
DeepSeek؛ LLM وزن باز چینی با استدلال قوی و هزینه پایین
DeepSeek خانوادهای از مدلهای بزرگ زبانی (LLM) است که برخی نسخههای آن برای استدلال، ریاضیات و برنامهنویسی توسعه یافتهاند. نسخههای مختلف این خانواده از نظر قابلیتها، اندازه و نیاز سختافزاری تفاوت دارند. برای مقایسه دقیق مدلهای زبانی بزرگ، باید نسخه مشخصی را بررسی کنید و کیفیت پاسخها، نتایج ارزیابی و منابع محاسباتی موردنیاز آن را بسنجید. شهرت یک مدل نقطه شروع بررسی است، نه تضمینی برای عملکرد بهتر در همه وظایف.
اگر هدف شما حل مسائل پیچیده، نوشتن کد یا اجرای مدل روی سختافزار شخصی است، کیفیت پاسخ، نتایج ارزیابی و منابع محاسباتی موردنیاز را در کنار هم بسنجید. عملکرد خوب در یک وظیفه، تضمین نمیکند که همان مدل برای تمام کارهای روزمره یا تولید محتوا نیز بهترین انتخاب باشد.
Qwen؛ LLM چینی Alibaba با استدلال قوی
Qwen خانوادهای از مدلهای زبانی بزرگ (LLM) و چندرسانهای است که برای تولید متن، برنامهنویسی، ریاضیات و برخی وظایف مبتنی بر تصویر و صوت توسعه یافته است. نسخههای این خانواده از نظر اندازه و قابلیتها متفاوتاند و برخی از آنها امکان دریافت وزنها و اجرای محلی را فراهم میکنند. اگر قصد دارید یک مدل تولید متن را روی کامپیوتر شخصی اجرا کنید، اندازه مدل، حافظه موردنیاز و سازگاری آن با سختافزارتان را در کنار کیفیت خروجی بررسی کنید.
کاربردهای مدل زبانی بزرگ (LLM) چیست؟
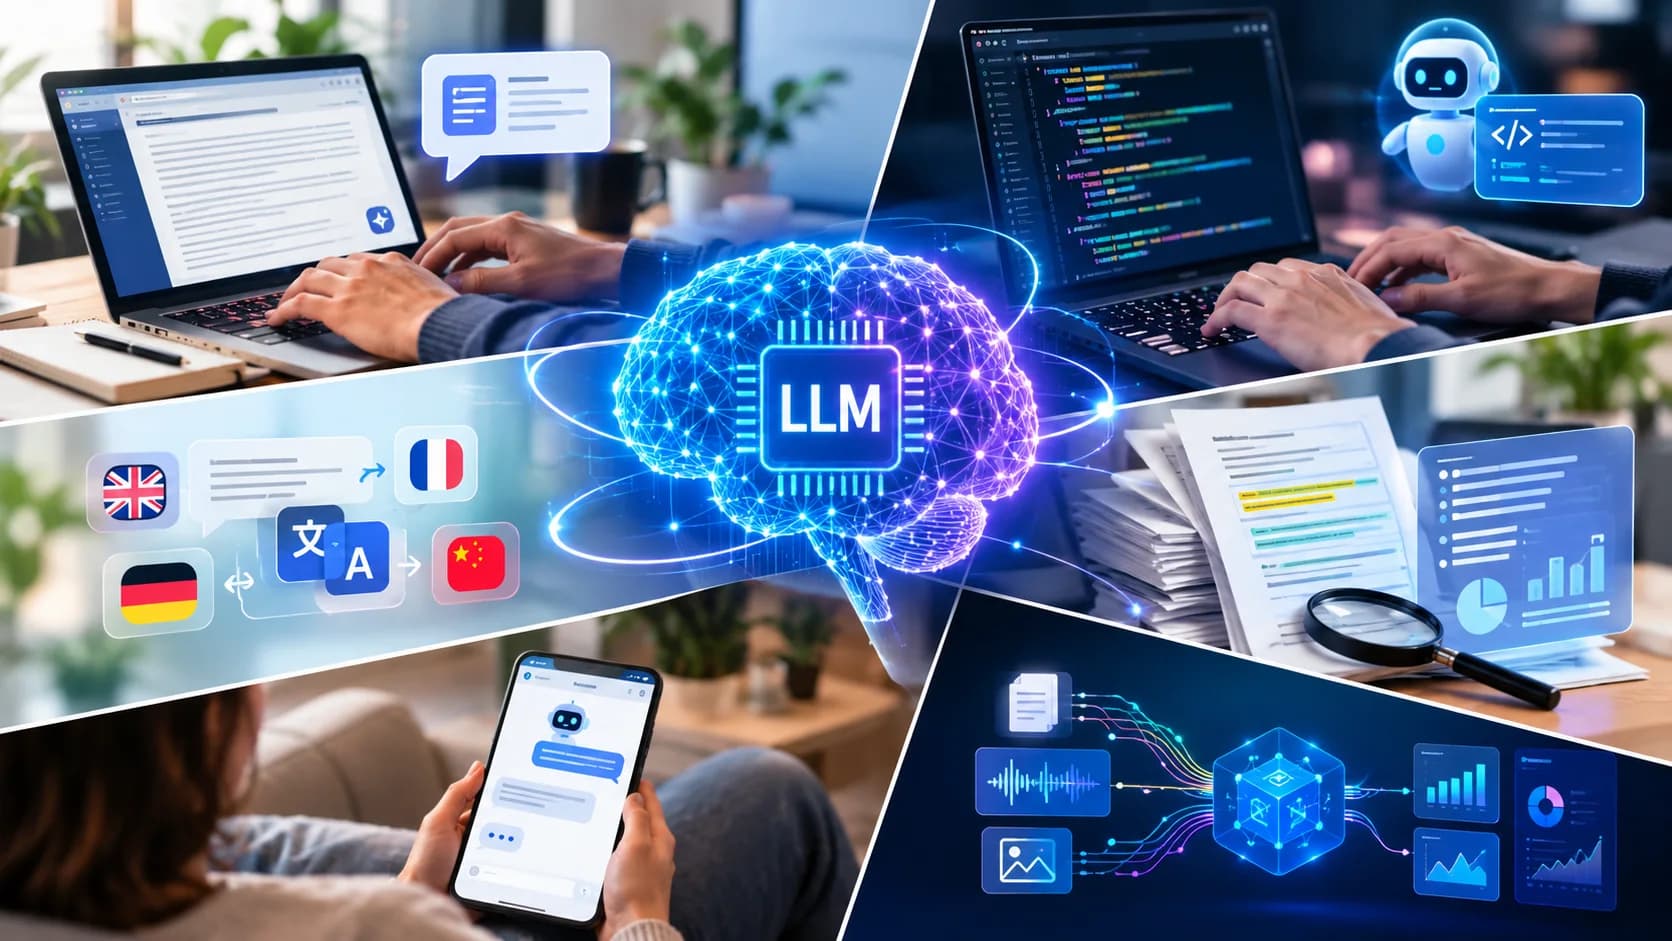
مدل زبانی بزرگ (LLM) برای تولید و خلاصهسازی متن، ترجمه، تحلیل اطلاعات، برنامهنویسی و ساخت دستیارهای هوشمند به کار میرود. این فناوری با استفاده از الگوهایی که طی آموزش یاد گرفته است، ورودی را پردازش میکند و متناسب با درخواست کاربر پاسخ میدهد. کاربرد دقیق هر مدل به قابلیتهای آن، کیفیت دادهها و نوع وظیفه بستگی دارد؛ بنابراین، همه مدلهای زبانی هوش مصنوعی در تمام کارها عملکرد یکسانی ندارند.
تولید و خلاصهسازی محتوا
از کاربردهای رایج مدلهای زبانی بزرگ یا LLM، میتوان به نوشتن پیشنویس مقاله، پیشنهاد عنوان، بازنویسی متن و خلاصهکردن گزارشهای طولانی اشاره کرد. برای مثال، یک کارشناس محتوا میتواند از مدل تولید متن بخواهد نکات اصلی یک گزارش را استخراج کند یا از دل یک متن طولانی، خلاصهای کوتاه برای انتشار در شبکههای اجتماعی بسازد. این ابزارها فرایند نگارش را سریعتر میکنند؛ اما بررسی صحت اطلاعات، ویرایش نهایی و کنترل منابع همچنان ضروری است.
ترجمه و تحلیل متن
مدلهای زبانی هوش مصنوعی فقط برای نوشتن متن نیستند! مدل زبانی بزرگ (LLM) علاوه بر تولید متن، در ترجمه، بازنویسی، دستهبندی و استخراج اطلاعات هم کاربرد دارند. برای نمونه، یک کسبوکار میتواند بازخوردهای مشتریان را تحلیل کند، شکایتهای پرتکرار را شناسایی کند یا محتوای خود را برای مخاطبان چندزبانه آماده کند. البته کیفیت ترجمه و تحلیل به زبان، موضوع و توانایی مدل بستگی دارد؛ بهویژه در متنهای تخصصی، بازبینی انسانی همچنان اهمیت دارد.
چتباتها و دستیارهای هوش مصنوعی
وقتی یک مدل زبانی بزرگ (LLM) به رابط گفتوگو و اطلاعات موردنیاز متصل میشود، میتواند بخشی از یک چتبات یا دستیار هوشمند باشد. چنین ابزاری میتواند به پرسشهای متداول مشتریان پاسخ دهد، کاربر را به اطلاعات مرتبط هدایت کند یا بخشی از وظایف تکراری پشتیبانی را انجام دهد. برای پاسخهای دقیقتر، میتوان مدل را به منابع معتبر متصل کرد. روندی که در معماری تولید افزوده با بازیابی اطلاعات (RAG) به کار میرود. بااینحال، پاسخهای سیستم باید آزمایش شوند و در موضوعات حساس، نظارت مناسب وجود داشته باشد.
چتباتها و دستیارهای هوش مصنوعی
تولید قطعهکد، توضیح توابع پیچیده، نوشتن آزمون و پیشنهاد راهحل برای خطاها از کاربردهای مدلهای زبانی بزرگ در برنامهنویسی هستند. برای مثال، برنامهنویس میتواند از یک دستیار هوش مصنوعی بخواهد تابعی در پایتون بنویسد یا دلیل بروز یک خطا را توضیح دهد. این قابلیتها به یادگیری و توسعه نرمافزار کمک میکنند؛ اما کد تولیدشده ممکن است خطا یا آسیبپذیری امنیتی داشته باشد. اجرای آزمونها و بازبینی کد پیش از استفاده، همچنان ضروری است.
آموزش و یادگیری شخصیسازیشده
در آموزش، مدل زبانی بزرگ (LLM) میتواند مفاهیم دشوار را با زبان ساده توضیح دهد، برای تمرین سؤال بسازد یا مثالهای بیشتری ارائه کند. دانشجو نیز میتواند از آن برای مرور درس، تمرین زبان خارجی یا یادگیری برنامهنویسی کمک بگیرد. برای مثال، اگر یک مفهوم را متوجه نشده باشد، میتواند درخواست کند همان موضوع با مثال سادهتر توضیح داده شود. البته پاسخ مدل همیشه دقیق نیست و بهتر است مطالب مهم با منابع آموزشی معتبر بررسی شوند.
محدودیتها و چالشهای مدلهای زبانی بزرگ
مدلهای زبانی بزرگ (LLM) با وجود تواناییهای چشمگیر، بدون مشکل نیستند. مهمترین چالشها عبارتاند از:
- - توهم هوش مصنوعی (Hallucination): مدل اطلاعاتی تولید میکند که کاملا ساختگی است اما کاملا واقعی به نظر میرسد. دلیلش این است که LLM «حقیقت» را نمیفهمد؛ فقط محتملترین توکن بعدی را پیشبینی میکند.
- - سوگیری مدل (Model Bias): اگر دادههای آموزشی شامل کلیشهها، اطلاعات نامتوازن یا دیدگاههای جانبدارانه باشند، مدل ممکن است همان سوگیریها را در پاسخهای خود بازتولید کند.
- - هزینه محاسباتی و نیاز سختافزاری: آموزش مدلهای بزرگ به منابع پردازشی و حافظه قابلتوجهی نیاز دارد. اجرای آنها نیز بسته به اندازه مدل، روش بهینهسازی و سختافزار میتواند پرهزینه باشد؛ هرچند مدلهای کوچکتر و نسخههای کوانتیزهشده روی بعضی کامپیوترهای شخصی هم اجرا میشوند.
- - چالشهای امنیتی و اخلاقی: مدلهای زبانی بزرگ ممکن است در تولید محتوای جعلی، پیامهای فیشینگ یا اطلاعات گمراهکننده مورد سوءاستفاده قرار بگیرند. حفظ حریم خصوصی، کاهش سوگیری و جلوگیری از انتشار اطلاعات نادرست نیز از چالشهای مهم استفاده از این فناوری هستند.
جمعبندی: مدل زبانی بزرگ (LLM) در یک نگاه
مدل زبانی بزرگ (LLM) یکی از فناوریهای مهم هوش مصنوعی مولد است که میتواند متن بنویسد، به سؤالها جواب بدهد، اطلاعات را تحلیل کند و حتی در برنامهنویسی کنارتان باشد. البته عملکرد این مدلها فقط به اندازهشان بستگی ندارد؛ معماری ترنسفورمر، تعداد و نوع پارامترها و شیوه آموزش هم نقش مهمی دارند. پس هرچه مدل بزرگتر باشد، لزوما قرار نیست جوابهای بهتری تحویل بگیرید!
با همه این قابلیتها، مدلهای زبانی بزرگ بینقص نیستند. گاهی اطلاعات نادرست تولید میکنند، بعضی وقتها با اطمینان کامل اشتباه میگویند و ممکن است سوگیریهای موجود در دادههای آموزشی را هم بازتاب دهند. به همین دلیل، هر پاسخ روان و قانعکنندهای را نباید حقیقت محض فرض کرد؛ مخصوصا وقتی پای اطلاعات تخصصی یا تصمیمهای مهم وسط است.
برای انتخاب مدل زبانی بزرگ مناسب، باید ببینید دقیقا چه کاری از آن میخواهید، چقدر به کیفیت پاسخها و پشتیبانی از زبان فارسی اهمیت میدهید و چه بودجه و سختافزاری در اختیار دارید. بعضی مدلها آنلاین استفاده میشوند و بعضی دیگر را میتوان با سختافزار مناسب روی کامپیوتر شخصی اجرا کرد. در نهایت، بهترین مدل لزوما معروفترین یا بزرگترین مدل نیست؛ مدلی است که کار شما را خوب راه بیندازد، با نیازتان جور باشد و بتوانید جوابهایش را بسنجید.
آیا ChatGPT یک مدل زبانی بزرگ (LLM) است؟
بله، ChatGPT یک دستیار هوش مصنوعی است که از مدلهای زبانی بزرگ (LLM) برای فهم ورودی و تولید پاسخ استفاده میکند. ChatGPT یک سرویس هوش مصنوعی است و GPT نام خانوادهای از مدلهای هوش مصنوعی است.


اولین دیدگاه مفید درباره این مطلب را شما بنویسید.