مدل وزن باز یا Open-Weight یعنی میتوانید فایلهای اصلی یک مدل آموزشدیده را دانلود کنید و آن را روی سیستم یا سرور خودتان اجرا کنید. بهجای فرستادن هر درخواست به یک سرویس آنلاین، خودتان انتخاب میکنید مدل کجا و با چه تنظیماتی کار کند. البته برای اجرا هنوز به نرمافزار و سختافزار مناسب نیاز دارید.
فرض کنید میخواهید یک دستیار برای خواندن اسناد شرکت داشته باشید، بدون اینکه فایلها را به یک چتبات آنلاین بفرستید. مدلهای وزنباز چنین امکانی میدهند. میتوانید نسخه دلخواه را نگه دارید، آن را به برنامههای داخلی وصل کنید و در صورت نیاز تغییرش دهید. سؤال بعدی این است: کدام مدل برای کار شما مناسب است و اجرای آن چقدر هزینه دارد؟
وزنهای یک مدل دقیقاً چه هستند؟
مدل هنگام آموزش، میلیاردها مقدار عددی را تنظیم میکند. به این پارامترهای یادگرفتهشده «وزن» میگویند. وقتی متن شما وارد مدل میشود، این اعداد همراه با ساختار شبکه در شکلگرفتن پاسخ نقش دارند. فایل وزنها را میتوان بخشی از آنچه مدل یاد گرفته دانست؛ نرمافزاری مثل Ollama یا LM Studio این فایلها را بارگذاری میکند و امکان گفتوگو با مدل را میدهد.
| نوع دسترسی | چه چیزی دریافت میکنید؟ | چه چیزی را باید جدا بررسی کنید؟ |
|---|---|---|
| چتبات آنلاین رایگان یا پولی | دسترسی به یک سرویس آماده | محدودیت مصرف، سیاست داده و امکانات سرویس |
| مدل وزنباز | وزنها و فایلهای منتشرشده مدل | مجوز، موتور اجرا و سختافزار موردنیاز |
| سیستم هوش مصنوعی متنباز طبق تعریف OSI | پارامترها، کد و اطلاعات لازم درباره دادهها در چارچوب تعریف | اجزای واقعاً منتشرشده و شرایط مجوز همان نسخه |
مدلهای وزنباز OpenAI؛ gpt-oss چیست؟
وزنهای gpt-oss با مجوز Apache 2.0 و سیاست استفاده این خانواده عرضه شدهاند. نسخههای اصلی ورودی و خروجی متنی دارند. اتصال به ابزارهایی مثل جستوجوی وب هم به برنامهای بستگی دارد که دور مدل میسازید؛ مدل میتواند درخواست استفاده از ابزار بدهد، اما خود ابزار باید در محیط اجرا آماده باشد.
چند مدل وزنباز که ارزش آشنایی دارند
مدلهای وزنباز از نسخههای کوچک برای کار روزمره تا مدلهای بسیار بزرگ سازمانی را شامل میشوند. برای شروع، تفاوت اندازه و نوع ورودی اهمیت بیشتری از شهرت نام مدل دارد. این چند نمونه نشان میدهند انتخابها چقدر متنوعاند.
| مدل یا خانواده | ویژگی اصلی | نکته اجرا |
|---|---|---|
| Qwen3.5-4B | مدل کوچکتر با ورودی متن و تصویر؛ Apache 2.0 | نسخه اصلی و نسخه کوانتایزشده مصرف حافظه یکسان ندارند. |
| Gemma 4 E2B و E4B | نسخههای طراحیشده برای اجرای روی دستگاه؛ Apache 2.0 | E به پارامتر مؤثر اشاره دارد؛ آن را ظرفیت حافظه ندانید. |
| Gemma 4 12B | مدل چندوجهی میانرده برای سیستم شخصی | قابلیتها به پشتیبانی موتور اجرا هم وابستهاند. |
| Ministral 3 3B Instruct | مدل کوچک با قابلیت بینایی؛ Apache 2.0 | نسخه Instruct، Reasoning و فرمت وزنها را از هم جدا کنید. |
| gpt-oss-20b | مدل استدلالی متنی با وزنهای قابل دریافت | نیاز حافظه به فرمت وزنها و تنظیمات اجرا بستگی دارد. |
| Inkling | مدل بزرگ با معماری MoE | ۹۷۵ میلیارد پارامتر کل؛ نیازمند زیرساخت متناسب با این ابعاد |
Qwen و Gemma برای شروع روی سیستم شخصی
Ministral؛ مدلهای کوچکتر Mistral
چرا تعداد پارامترهای فعال میتواند گمراهکننده باشد؟
پس یک مدل با ۴۱ میلیارد پارامتر فعال، لزوماً به اندازه یک مدل متراکم ۴۱ میلیارد پارامتری حافظه نمیخواهد. حجم کل وزنها و شیوه تقسیم آنها میان CPU و GPU در انتخاب سختافزار تعیینکننده است. حتی نسخهای با نام Small ممکن است هنوز برای اجرای خانگی بسیار بزرگ باشد.
کوانتایزیشن؛ چطور حجم مدل کمتر میشود؟
| مثال فرضی | حد حسابی حجم وزنها | چه چیزی در این عدد نیست؟ |
|---|---|---|
| مدل متراکم ۸ میلیارد پارامتری با ۱۶ بیت برای هر پارامتر | حدود ۱۶ گیگابایت اعشاری | حافظه اجرا، Context، بافرها و سربار فایل |
| همان مدل فرضی با ۴ بیت برای هر پارامتر | حدود ۴ گیگابایت اعشاری | اطلاعات کمکی کوانتایزیشن و بخشهایی با دقت متفاوت |
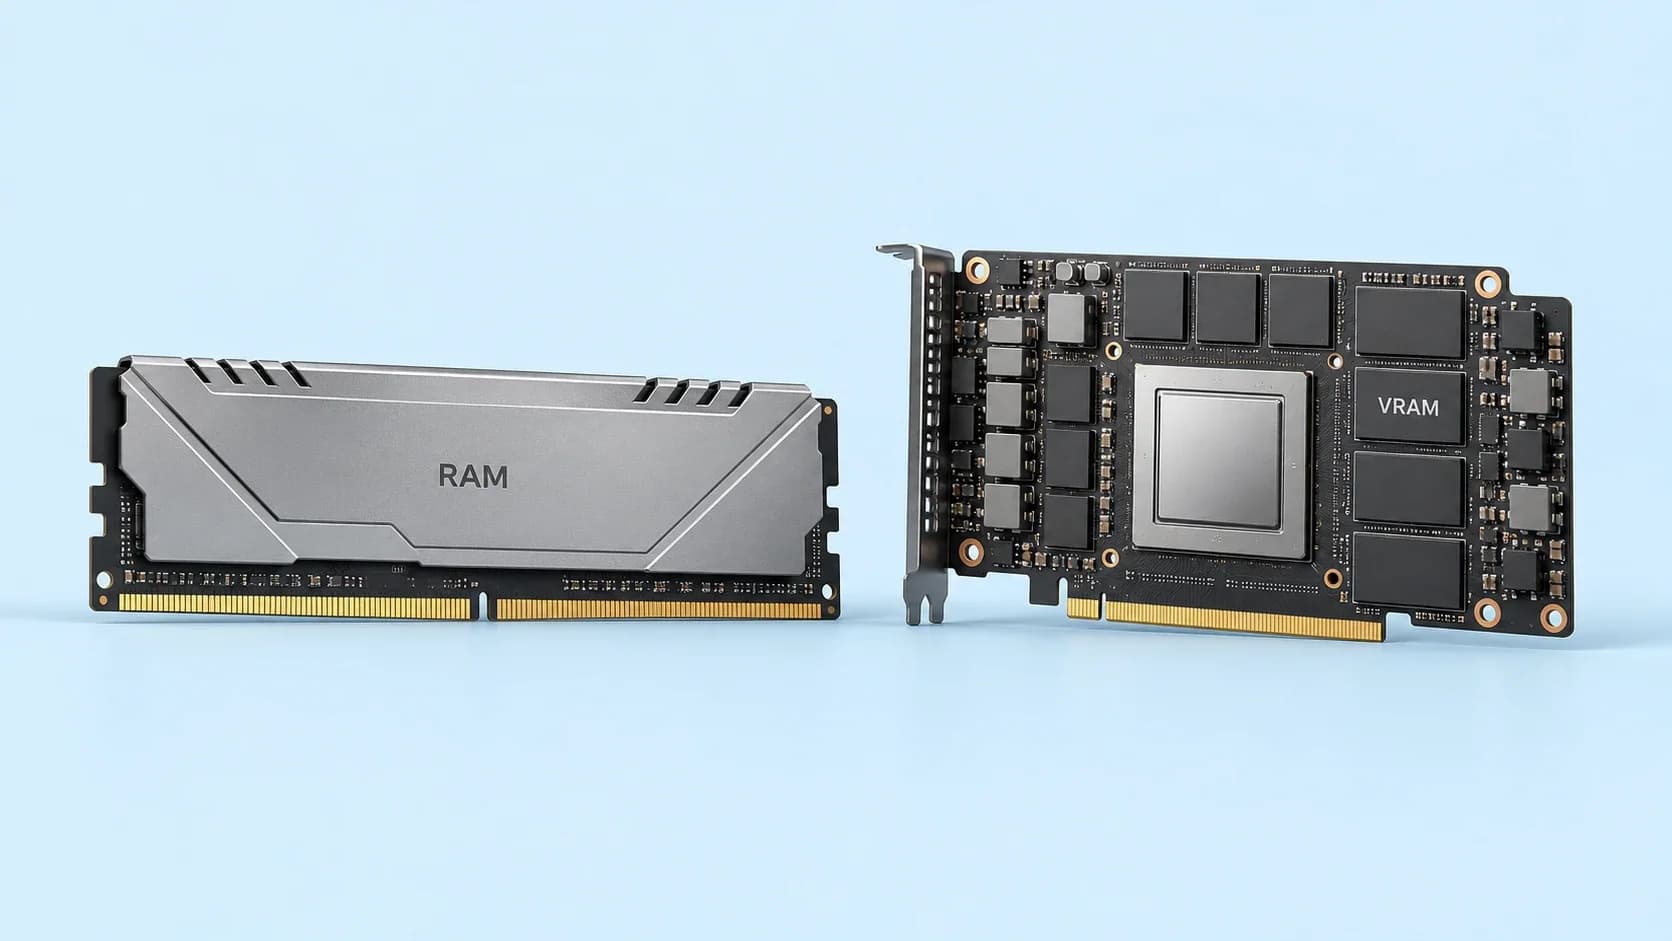
محاسبه جدول ساده است: تعداد پارامترها را در تعداد بیت هر پارامتر ضرب میکنیم و بر ۸ تقسیم میکنیم. اما مدل هنگام اجرا به حافظه بیشتری نیاز دارد؛ متن گفتوگو، بافرها و اطلاعات کمکی هم فضا میگیرند. این جدول حجم خام وزنها را نشان میدهد، نه کل RAM یا VRAM لازم برای اجرا.
مدل وزن باز چقدر رم و حافظه گرافیکی میخواهد؟
برای شروع با سیستم فعلی، یک مدل کوچکتر و ورودی کوتاه انتخاب کنید. ببینید پاسخ اول چقدر طول میکشد و ادامه متن با چه سرعتی تولید میشود. بعضی موتورهای اجرا میتوانند بخشی از مدل را روی CPU و بخشی را روی GPU قرار دهند. این راه گاهی مشکل کمبود حافظه را حل میکند، ولی سرعت آن به سختافزار و نحوه تقسیم مدل بستگی دارد.
اجرای مدل با Ollama و LM Studio
اگر کار با محیط گرافیکی را ترجیح میدهید، LM Studio امکان انتخاب و بارگذاری مدل را از داخل برنامه فراهم میکند. Ollama هم برای اجرای مدل با فرمان و اتصال آن به برنامههای دیگر کاربرد دارد. در هر دو، ابتدا یک مدل سازگار را دریافت میکنید و بعد گفتوگو را شروع میکنید.
ollama run qwen3.5:4bollama run gemma4:e2bاجرای محلی چه تغییری در حریم خصوصی میدهد؟
اما اگر جستوجوی وب، افزونه یا سرویس خارجی به این مجموعه وصل کنید، مسیر داده عوض میشود. برای کار تیمی، دسترسی به گفتوگوها، فایلهای ثبت رویداد و نسخههای پشتیبان هم باید مشخص باشد. مزیت میزبانی شخصی این است که اختیار بیشتری روی این جزئیات دارید؛ تنظیم و نگهداری آنها هم بر عهده خودتان است.
وقتی وزنها رایگاناند، برای چه چیزهایی هزینه میدهیم؟
فایل مدل ممکن است رایگان باشد، اما اجرای آن برق، فضای ذخیرهسازی و سختافزار مصرف میکند. راهاندازی و نگهداری هم زمان میبرد. اگر ماهی چند بار از مدل استفاده میکنید، خرید یک سیستم گران شاید توجیه نداشته باشد. برای استفاده روزانه یک تیم، حساب هزینهها فرق میکند؛ آنجا باید خرید و نگهداری دستگاه را با هزینه سرویس یا اجاره منابع مقایسه کرد.
چه زمانی کیس یا سرور هوش مصنوعی لازم میشود؟
اگر یک مدل کوچک کارتان را راه میاندازد، با همان سیستم شروع کنید. نیاز به سختافزار قویتر معمولاً وقتی جدی میشود که سراغ مدل بزرگتر، متنهای طولانی یا چند کاربر همزمان میروید. برای سرویس دائمی، پایداری و نگهداری هم کنار سرعت قرار میگیرند. در سیستم چندگرافیکی، نرمافزار باید بتواند مدل را بین کارتها تقسیم کند؛ جمع ظرفیت کارتها همیشه مثل یک حافظه یکپارچه قابل استفاده نیست.
- نام و نسخه مدل، فرمت وزنها و نرمافزار اجرا
- نمونهای از سؤالها یا اسنادی که مدل باید پردازش کند
- طول ورودی، تعداد کاربران همزمان و ساعت استفاده روزانه
- ظرفیت حافظه، GPU سازگار و امکان ارتقای سیستم
- سرعت و کیفیت پاسخ با همان مدل و تنظیمات موردنیاز
پرسشهای رایج درباره مدلهای وزنباز
آیا میتوان خود ChatGPT را دانلود و آفلاین اجرا کرد؟
خیر. gpt-oss از مدلهای وزنباز OpenAI است و میتوان آن را مستقل اجرا کرد، اما همان سرویس ChatGPT و مجموعه امکانات آن نیست.
آیا بدون کارت گرافیک هم میتوان مدل اجرا کرد؟
بله، بعضی مدلهای کوچک روی CPU و رم سیستم اجرا میشوند. سرعت به مدل، پردازنده و حافظه آزاد بستگی دارد؛ برای کارهای سنگینتر، GPU سازگار میتواند انتخاب بهتری باشد.
آیا هر مدل وزنباز برای استفاده تجاری آزاد است؟
نه همیشه. مجوز هر مدل شرایط خودش را دارد. برای استفاده در محصول یا کسبوکار، مجوز و سیاست استفاده همان نسخه را بخوانید.
آیا بعد از دانلود مدل دیگر اینترنت لازم نیست؟
برای گفتوگو با مدل محلی، بعد از دانلود فایلها و ابزارهای لازم معمولاً اینترنت نمیخواهید. جستوجوی وب، مدل ابری و سرویسهای متصل همچنان به اینترنت نیاز دارند.


اولین دیدگاه مفید درباره این مطلب را شما بنویسید.