هوش مصنوعی لوکال (Local AI) یا آفلاین (Offline AI) به شما اجازه میدهد مدل را روی کامپیوتر، ورکاستیشن یا سرور تحت کنترل خودتان اجرا کنید. در این هوش مصنوعی محلی، پرسشها، فایلها و فرایند تولید پاسخ میتوانند داخل دستگاه یا شبکه داخلی باقی بمانند؛ حتی زمانی که اینترنت قطع است. این ویژگی برای تیمهای توسعه، شرکتهایی با اسناد محرمانه، استودیوهای تولید محتوا و کسبوکارهایی که به دسترسی پایدار نیاز دارند، یک مزیت عملی است.
اما آیا یک سرور شخصی واقعاً میتواند جای هوش مصنوعی آنلاین را بگیرد؟ چه مدلی روی ۱۶، ۳۲ یا ۹۶ گیگابایت حافظه گرافیکی اجرا میشود؟ تفاوت یک کیس AI با NVIDIA DGX Spark چیست؟ در این راهنما، ابتدا انواع مدل و سختافزار را بررسی میکنیم، سپس ظرفیت اجرای مدلها را توضیح میدهیم و محصولات استوکلند را بهعنوان مثال واقعی کنار این اصول قرار میدهیم.
هوش مصنوعی لوکال و آفلاین دقیقاً چه تفاوتی دارند؟
«لوکال» محل اجرای مدل را مشخص میکند: محاسبات روی دستگاه خودتان یا سرور سازمان انجام میشود. «آفلاین» به وابستگی نداشتن فرایند اجرا به اینترنت اشاره دارد. بنابراین یک سیستم میتواند لوکال باشد، ولی برای جستوجوی وب یا اتصال به ابزار ابری همچنان اینترنت بخواهد. از طرف دیگر، یک سرور داخلی میتواند از طریق شبکه شرکت به چند کاربر خدمات بدهد و بدون اتصال به اینترنت عمومی کار کند.
برای اجرای واقعاً آفلاین، فقط دانلود وزن مدل کافی نیست. نرمافزار اجرا، توکنایزر، فایلهای تنظیمات، کتابخانهها و درایورها نیز باید آماده باشند. اگر تحلیل PDF، تشخیص متن تصویر، تبدیل گفتار به متن یا جستوجوی اسناد میخواهید، تمام اجزای این زنجیره باید محلی باشند. استفاده از یک مدل محلی همراه با سرویس ابری OCR یا Embedding، کل فرایند را آفلاین نمیکند.
- اجرای شخصی: مدل و رابط گفتوگو روی همان کامپیوتر قرار دارند؛ مناسب یادگیری، تولید متن و کمک به برنامهنویسی.
- سرور داخلی: یک دستگاه قدرتمند در شبکه شرکت به چند کاربر یا نرمافزار پاسخ میدهد؛ ظرفیت همزمانی باید جداگانه سنجیده شود.
- اجرای ترکیبی: کارهای روزمره و اسناد حساس روی سرور داخلی پردازش میشوند و کارهای منتخب با اجازه و سیاست مشخص به سرویس آنلاین میروند.
برتریهای هوش مصنوعی آفلاین نسبت به سرویسهای آنلاین
۱. کنترل بیشتر بر داده و حریم خصوصی
در اجرای محلی میتوانید مسیر ذخیره و پردازش داده را تعیین کنید: متن قرارداد، کد اختصاصی، پرونده پژوهشی یا مکاتبات داخلی مجبور نیست برای تولید پاسخ از سازمان خارج شود. همچنین میتوان سطح دسترسی کاربران، مدت نگهداری مکالمات و محل نسخه پشتیبان را با قواعد شرکت هماهنگ کرد. این کنترل برای سازمانی که مالکیت و محل پردازش داده برایش مهم است، ارزش مستقلی دارد.
البته آفلاین بودن بهتنهایی امنیت کامل ایجاد نمیکند. دسترسی غیرمجاز به دستگاه، افزونه نامطمئن یا ذخیره نامناسب فایلها همچنان مشکلساز است. مزیت سرور داخلی در این است که امکان طراحی و کنترل این لایهها را در اختیار دارید؛ کیفیت اجرای آنها به مدیریت سیستم بستگی دارد.
۲. ادامه کار هنگام قطع یا اختلال اینترنت
پس از نصب کامل، یک مدل آفلاین برای خلاصهسازی سند، تولید متن یا پاسخ به پرسش درباره فایلهای داخلی به اتصال خارجی وابسته نیست. برای محیطهایی با ارتباط ناپایدار، کارگاهها، دفاتر شعب و تیمهایی که توقف کار برایشان هزینه دارد، این مزیت محسوس است. برق، سلامت سختافزار و دسترسی به شبکه داخلی همچنان لازماند.
۳. اختیار در انتخاب مدل و نسخه
در یک سیستم لوکال میتوانید مدل کوچک و سریع را برای طبقهبندی انتخاب کنید و مدل بزرگتر را برای تحلیل پیچیده نگه دارید. امکان تثبیت نسخه مدل، تنظیم قالب پاسخ و ارزیابی تغییرات پیش از ارتقا هم وجود دارد. این موضوع در سامانههایی مهم است که باید رفتار نسبتاً قابل تکرار داشته باشند و تغییر ناگهانی پاسخها به فرایند کسبوکار آسیب میزند.
۴. هزینه قابل برنامهریزی در مصرف مداوم
اگر حجم پردازش دائمی و قابل پیشبینی باشد، مالکیت سختافزار میتواند هزینه هر کار موفق را کاهش دهد. در اجرای محلی، صورتحساب به تعداد توکنهای سرویس خارجی وابسته نیست؛ اما هزینه اولیه دستگاه، برق، نگهداری، ارتقا و زمان متخصص باقی میماند. برای مصرف پراکنده یا پروژه کوتاه، سرویس آنلاین ممکن است اقتصادیتر باشد. نتیجه به میزان استفاده واقعی از دستگاه بستگی دارد.
۵. اتصال مستقیم به اسناد و نرمافزارهای داخلی
یک سرور AI داخلی میتواند به آرشیو فایلها، سامانه تیکتینگ یا پایگاه دانش شرکت متصل شود. برای پاسخگویی به پرسشهای سازمانی، اغلب ابتدا بازیابی اسناد مرتبط یا RAG ارزش بیشتری از بزرگتر کردن مدل دارد. مدل مناسب همراه با منابع دقیق میتواند پاسخ کاربردیتری از یک مدل بزرگِ بدون دسترسی به اطلاعات شما بسازد.
مقایسه کامل هوش مصنوعی لوکال با آنلاین
انتخاب بر اساس نیاز واقعی
| معیار | هوش مصنوعی لوکال / آفلاین | هوش مصنوعی آنلاین |
|---|---|---|
| مسیر داده | قابل نگهداری در دستگاه یا شبکه خودتان، با پیکربندی درست | پردازش در زیرساخت ارائهدهنده؛ قواعد داده تابع سرویس و قرارداد |
| اینترنت | برای اجرای آمادهشده لازم نیست؛ وبگردی به اتصال نیاز دارد | استفاده از سرویس خارجی به ارتباط شبکه وابسته است |
| شروع کار | نیازمند نصب، انتخاب مدل و تنظیم سختافزار | معمولاً شروع سادهتر از طریق رابط یا API |
| کیفیت پاسخ | وابسته به مدل، زبان، داده، Quantization و ابزارها | وابسته به مدل و پلن؛ دسترسی به مدلهای پرقدرت میتواند مزیت باشد |
| هزینه | خرید و نگهداری زیرساخت؛ مناسب بررسی برای مصرف مداوم | اشتراک یا پرداخت مصرفی؛ مناسب بررسی برای مصرف متغیر |
| تعداد کاربران | محدود به حافظه، توان دستگاه و نرمافزار سرویسدهی | مقیاسپذیری ارائهدهنده همراه با سهمیه و محدودیتهای سرویس |
| سفارشیسازی | کنترل نسخه، RAG، قالب پاسخ و در موارد مناسب Fine-tuning | وابسته به امکانات و محدودیتهای ارائهدهنده |
| اطلاعات تازه | نیازمند داده تازه داخلی یا ابزار جستوجوی متصل | در صورت داشتن ابزار جستوجو به اطلاعات تازه دسترسی مییابد |
| مسئولیت عملیات | نصب، امنیت، مانیتورینگ، پشتیبان و ارتقا با مالک سیستم | بخش مهم عملیات زیرساخت با ارائهدهنده |
محلی یا آنلاین بودن، بهخودیخود میزان هوشمندی را تعیین نمیکند. اگر همان مدل با همان وزنها، دقت عددی، تنظیمات و ابزارها در دو محل اجرا شود، کیفیت باید با آزمون یکسان مقایسه شود. اختلاف معمولاً از مدل انتخابی، فشردهسازی، طول ورودی، منابع در دسترس و طراحی نرمافزار میآید. پس «لوکال» یک شیوه استقرار است و بهتنهایی رتبه کیفیت محسوب نمیشود.
خدماتی مانند ChatGPT، Claude و Gemini مجموعهای از مدل، رابط، ابزار و زیرساخت هستند. مقایسه یک فایل مدل محلی با کل این خدمات بدون مشخص کردن وظیفه، دقیق نیست. برای نمونه، خلاصهسازی پروندههای داخلی، حل یک مسئله دشوار، تحلیل تصویر و جستوجوی خبر روز چهار آزمون متفاوتاند و ممکن است چهار انتخاب متفاوت داشته باشند.
چه مدلهای هوش مصنوعی را میتوان بهصورت لوکال نصب کرد؟
مدلهای قابل نصب بسیار متنوعاند؛ فهرست همه نسخهها، تنظیمهای تخصصی و فایلهای فشردهشده در یک مقاله ثابت نمیماند. دستهبندی زیر خانوادههای اصلی و نمونههای مشخص و قابل بررسی را نشان میدهد. نام مدل را همراه نسخه، مجوز و فرمت فایل بررسی کنید؛ شهرت یک برند به معنی یکسان بودن همه مدلهای آن نیست.
نقشه مدلهای قابل اجرای محلی
| دسته | نمونه مشخص | کاربرد و نکته انتخاب |
|---|---|---|
| متن و استدلال | Qwen3-8B / 14B / 32B؛ Qwen3.6-27B | گفتوگو، تحلیل متن و کمک به کدنویسی؛ نسخه جدیدتر نیازمند Runtime سازگار |
| کدنویسی | Qwen3-Coder-30B-A3B-Instruct | مدل MoE برای کار با کد؛ ۳۰٫۵B پارامتر کل و ۳٫۳B فعال |
| استدلال با مدل تقطیرشده | DeepSeek-R1-Distill-Qwen-14B / 32B | نمونههای کوچکتر؛ با DeepSeek-R1 کامل یکسان نیستند |
| متن در مقیاس بزرگتر | Llama-3.3-70B-Instruct | مدل متنی ۷۰B؛ آزمون فارسی و بررسی مجوز لازم است |
| مدلهای میانرده | Mistral Small 3.1 24B؛ Microsoft Phi-4 14B | گفتوگو و استدلال؛ Mistral Small 3.1 تحلیل تصویر هم دارد |
| چندوجهی | Gemma 3 4B / 12B / 27B؛ Gemma 4 12B / 31B | تحلیل متن و تصویر؛ قابلیت صوت بسته به نسخه فرق میکند |
| MoE با وزن باز | gpt-oss-20b / 120b | مدلهای متنی و استدلال؛ فرمت MXFP4 و پشتیبانی موتور اجرا مهم است |
| تولید تصویر | FLUX.1-schnell | تولید تصویر محلی؛ رزولوشن و اجزای زنجیره مصرف حافظه را تغییر میدهند |
| گفتار به متن | Whisper large-v3 با faster-whisper | پیادهسازی محلی رونویسی صوت؛ کیفیت باید روی صدای واقعی سنجیده شود |
| جستوجوی اسناد | Qwen3-Embedding-0.6B و مدلهای Reranker | تبدیل سند به بردار و رتبهبندی نتایج؛ جایگزین مدل پاسخساز نیستند |
Qwen: از مدل سبک تا مدل چندوجهی و تخصصی کد
DeepSeek: مدل کامل را از نسخه Distill جدا کنید
Llama، Mistral و Phi: گزینههایی برای نیازهای متفاوت
Gemma و مدلهای چندوجهی: دیدن تصویر با ساختن تصویر فرق دارد
gpt-oss: تعداد پارامتر تنها معیار ظرفیت نیست
تصویر، صوت و RAG: هوش مصنوعی آفلاین فقط چت نیست
برای کاربرد فارسی، اندازه مدل فقط یک نشانه است. نگارش رسمی و محاورهای، اعداد فارسی، نیمفاصله، اصطلاحات تخصصی، متن اسکنشده و لهجه در صوت میتوانند نتیجه را تغییر دهند. بهتر است چند مدل را با نمونههای واقعی خودتان مقایسه کنید. در RAG نیز کیفیت استخراج متن و بازیابی سند میتواند از اختلاف دو مدل زبانی مهمتر باشد.
پارامتر چیست و چرا حافظه GPU اینقدر مهم است؟
پارامترها اعداد آموختهشده مدلاند. حرف B در نام مدل معمولاً به میلیارد اشاره دارد؛ مثلاً ۸B یعنی حدود هشت میلیارد پارامتر. مدل برای تولید پاسخ باید وزنها را از حافظه بخواند و محاسبات لازم را انجام دهد. برای همین ظرفیت و پهنای باند حافظه نقش مهمی دارند. تعداد پارامتر بیشتر الزاماً کیفیت بهتر در همه کارها یا سرعت بیشتر ایجاد نمیکند.
Quantization یا کوانتیزهسازی، وزنها را با دقت عددی کمحجمتری ذخیره میکند. BF16 و FP16 معمولاً برای هر وزن دو بایت میخواهند؛ ۸ بیت حدود یک بایت و ۴ بیت در حالت نظری نیمبایت. فایل واقعی به مقیاسها، فراداده و بخشهایی که با دقت بالاتر نگهداری شدهاند هم نیاز دارد. پس «مدل ۳۲B چهاربیتی = دقیقاً ۱۶GB» فقط یک محاسبه خام است.
حافظه خام وزنها؛ بدون سربار و حافظه مکالمه
| اندازه اسمی مدل | FP16 / BF16 | ۸ بیت | ۴ بیت نظری |
|---|---|---|---|
| ۸ میلیارد پارامتر | ۱۶ GB | ۸ GB | ۴ GB |
| ۱۴ میلیارد پارامتر | ۲۸ GB | ۱۴ GB | ۷ GB |
| ۳۲ میلیارد پارامتر | ۶۴ GB | ۳۲ GB | ۱۶ GB |
| ۷۰ میلیارد پارامتر | ۱۴۰ GB | ۷۰ GB | ۳۵ GB |
| ۱۲۰ میلیارد پارامتر | ۲۴۰ GB | ۱۲۰ GB | ۶۰ GB |
| ۲۰۰ میلیارد پارامتر | ۴۰۰ GB | ۲۰۰ GB | ۱۰۰ GB |
یک مثال دقیق: Qwen3-32B روی کارت ۲۴ گیگابایتی
نتیجه عملی روشن است: جا شدن فایل مدل روی GPU، به معنی اجرای همان مدل با مکالمه بسیار طولانی یا چند کاربر همزمان نیست. اگر یک مدل با ورودی کوتاه اجرا میشود ولی با فایل بزرگ خطای کمبود حافظه میدهد، ممکن است وزنها مشکلی نداشته باشند و فشار از حافظه مکالمه آمده باشد.
با هر ظرفیت VRAM چند میلیارد پارامتر میتوان اجرا کرد؟
جدول زیر پیشنهاد اولیه برای یک GPU، استنتاج یک کاربر و شروع با Context حدود ۴K است. ستونها «سقف قطعی» نیستند؛ فرض اصلی، نسخه چهاربیتی مناسب و Runtime سازگار است. برای سفارش نهایی، فایل دقیق مدل، حجم واقعی وزن و حافظه آزاد دستگاه باید بررسی شود.
راهنمای محافظهکارانه ظرفیت استنتاج محلی
| حافظه GPU | اندازههای مناسب برای بررسی | شرط و محدودیت |
|---|---|---|
| ۸ تا ۱۲ GB | مدلهای ۳B تا ۸B با Q4 | برای شروع و کار سبک؛ طول ورودی و ظرفیت آزاد مهم است |
| ۱۶ GB | ۸B تا ۱۴B با Q4؛ gpt-oss-20b در قالب سازگار | ۳۲B متراکم در نسخههای متداول Q4 معمولاً کامل روی یک GPU جا نمیشود |
| ۲۴ GB | ۱۴B تا ۳۲B با Q4 | مدل ۳۲B نزدیکتر به مرز حافظه؛ Context محدود و آزمون لازم |
| ۳۲ GB | ۲۷B تا ۳۲B با Q4، با فضای بیشتر نسبت به ۲۴GB | سربار تحلیل تصویر و کاربران اضافی جداگانه محاسبه شود |
| ۴۸ GB | مدل ۷۰B با Q4، بسته به فایل | برای ۷۰B، Context و همزمانی میتوانند محدود باشند |
| ۷۲ GB | ۷۰B با Q4 و فضای بیشتر برای Cache | ۷۰B با ۸ بیت لزوماً همراه سربار جا نمیشود |
| ۸۴ تا ۹۶ GB | ۷۰B با Q4؛ gpt-oss-120b در فرمت و Runtime مناسب | نام مدل ۱۲۰B بهتنهایی تضمین سازگاری نیست |
| ۱۲۸ GB حافظه یکپارچه DGX Spark | ۷۰B و ۱۲۰B مناسب بررسی؛ تا ۲۰۰B طبق اعلام انویدیا | حافظه بین CPU و GPU مشترک است؛ سقف ۲۰۰B مشروط است |
اگر وزن مدل از VRAM بزرگتر باشد، بعضی موتورها بخشی از مدل را در RAM سیستم میگذارند؛ به این کار Offload میگویند. امکان اجرا افزایش مییابد، اما جابهجایی داده و سرعت حافظه اصلی میتوانند پاسخ را کند کنند. دو سوکت CPU و رم فراوان ارزش دارند، ولی جایگزین مستقیم حافظه گرافیکی پرسرعت نیستند.
در سیستم چند GPU نیز جمع ظرفیتها فقط وقتی به اجرای یک مدل کمک میکند که موتور، تقسیم مدل را پشتیبانی کند. دو کارت ۲۴GB الزاماً مانند یک کارت ۴۸GB رفتار نمیکنند. نوع تقسیم، اتصال بین کارتها، مسیر PCIe و پشتیبانی نرمافزار در سرعت نهایی دخالت دارند. تعداد کارت قابل نصب را از تعداد گزینههای فروشگاه یا نام کیس نتیجه نگیرید.
کدام سختافزار برای هوش مصنوعی آفلاین مناسب است؟
- کامپیوتر عمومی با CPU: برای یادگیری، مدلهای کوچک و بعضی پردازشهای کمحجم؛ سرعت مدلهای بزرگ باید آزمایش شود.
- ورکاستیشن با GPU مجزا: انتخابی قابل ارتقا برای مدل زبانی، تصویر و کدنویسی؛ VRAM و سازگاری موتور در اولویتاند.
- دستگاه با حافظه یکپارچه: مانند DGX Spark یا برخی پلتفرمهای دیگر؛ ظرفیت مشترک بالاتر مفید است، ولی پهنای باند و معماری با GPU مجزا تفاوت دارد.
- سرور رکمونت: برای استقرار در رک، مدیریت سرویس و بار سازمانی؛ برق، تهویه، شبکه و شرایط محیط باید متناسب باشند.
- سیستم چندشتابدهنده دیتاسنتری: برای مدلهای بسیار بزرگ، آموزش و سرویسدهی در مقیاس بالا؛ هزینه و نیازهای زیرساخت با یک کیس شخصی قابل قیاس مستقیم نیست.
در انتخاب قطعات، ابتدا مدل و وظیفه را مشخص کنید و بعد سختافزار را انتخاب کنید. VRAM تعیین میکند چه چیزی در حافظه گرافیکی جا میشود؛ پهنای باند و پردازش تعیین میکنند با چه سرعتی پاسخ میگیرید. RAM برای بارگذاری، Offload، دیتاست و سرویسهای جانبی لازم است. SSD سریع بارگذاری را بهتر میکند، ولی فضای ذخیرهسازی چندترابایتی بهتنهایی ظرفیت اجرای مدل را افزایش نمیدهد.
خانواده DGX انویدیا؛ از میز کار تا دیتاسنتر
NVIDIA DGX Spark: حافظه زیاد در دستگاهی کوچک
DGX Spark برای توسعه، آزمایش مدلهای بزرگتر و کار با اکوسیستم نرمافزاری انویدیا گزینه قابل بررسی است. هنگام انتخاب میان Spark و ورکاستیشن GPU مجزا، علاوه بر ظرفیت حافظه، سرعت مدل هدف، امکان ارتقا و سازگاری نرمافزار با معماری Arm را مقایسه کنید. ممکن است یک GPU مجزا برای مدل کوچکتر سریعتر باشد؛ بدون آزمون یکسان نمیتوان حکم کلی داد.
DGX Station: کلاس متفاوتی از AI دسکتاپ
DGX H100، H200، B200 و سیستمهای رکمقیاس
سرورهای استوکلند چند پارامتر را هندل میکنند؟
محصولات PC Land و سیستمهای AI کاتالوگ، عمدتاً بر پایه پردازنده ثابت و انتخاب رم، SSD و GPU عرضه شدهاند. در نتیجه نسبت دادن یک عدد مانند «۷۰ میلیارد پارامتر» به نام Astra یا Atlas، بدون ذکر GPU انتخابی، دقیق نیست. جدول زیر مشخصات ثبتشده هر محصول را کنار سناریوی استنتاج قرار میدهد. اینها بررسی کاتالوگ و محاسبه ظرفیتاند؛ بنچمارک حضوری دستگاه نیستند.
مشخصات ثبتشده و ظرفیت وابسته به کانفیگ
| مدل در استوکلند | پلتفرم ثبتشده | حافظه | سناریوی ظرفیت استنتاج |
|---|---|---|---|
| PC Land Astra | 2 × Xeon Gold 6150 | DDR4 ECC | ۱۶GB GPU: ۸–۱۴B Q4؛ ۲۴–۳۲GB: تا حدود ۳۲B Q4؛ ۴۸–۹۶GB: ۷۰B Q4، مشروط به کانفیگ |
| PC Land Orion | 2 × Xeon Platinum 8173M | DDR4 ECC | ۱۶GB GPU: ۸–۱۴B Q4؛ ۲۴–۳۲GB: تا حدود ۳۲B Q4؛ ۴۸–۹۶GB: ۷۰B Q4، مشروط به کانفیگ |
| ASUS PA602 | 2 × Xeon Gold 8269CY | DDR4 ECC | ۱۶GB GPU: ۸–۱۴B Q4؛ ۲۴–۳۲GB: تا حدود ۳۲B Q4؛ ۴۸–۹۶GB: ۷۰B Q4، مشروط به کانفیگ |
| HP Z8 G5 | 2 × Xeon Platinum 8481C | DDR5 ECC | ۱۶GB GPU: ۸–۱۴B Q4؛ ۲۴–۳۲GB: تا حدود ۳۲B Q4؛ ۴۸–۹۶GB: ۷۰B Q4، مشروط به کانفیگ |
| PC Land Helios T1 | 2 × Xeon Platinum 8582C | DDR5 ECC | ۱۶GB GPU: ۸–۱۴B Q4؛ ۲۴–۳۲GB: تا حدود ۳۲B Q4؛ ۴۸–۹۶GB: ۷۰B Q4، مشروط به کانفیگ |
| PC Land Helios T2 | 2 × Xeon Platinum 8582C | DDR5 ECC | ۱۶GB GPU: ۸–۱۴B Q4؛ ۲۴–۳۲GB: تا حدود ۳۲B Q4؛ ۴۸–۹۶GB: ۷۰B Q4، مشروط به کانفیگ |
| PC Land Helios T3 | 2 × Xeon Platinum 8481C | DDR5 ECC | ۱۶GB GPU: ۸–۱۴B Q4؛ ۲۴–۳۲GB: تا حدود ۳۲B Q4؛ ۴۸–۹۶GB: ۷۰B Q4، مشروط به کانفیگ |
| PC Land Helios T4 | 2 × Xeon Platinum 8383C | DDR4 ECC | ۱۶GB GPU: ۸–۱۴B Q4؛ ۲۴–۳۲GB: تا حدود ۳۲B Q4؛ ۴۸–۹۶GB: ۷۰B Q4، مشروط به کانفیگ |
| PC Land Atlas R1 | 2 × Xeon Platinum 8582C | DDR5 ECC | ۱۶GB GPU: ۸–۱۴B Q4؛ ۲۴–۳۲GB: تا حدود ۳۲B Q4؛ ۴۸–۹۶GB: ۷۰B Q4، مشروط به کانفیگ |
| PC Land Atlas R2 | 2 × Xeon Platinum 8582C | DDR5 ECC | ۱۶GB GPU: ۸–۱۴B Q4؛ ۲۴–۳۲GB: تا حدود ۳۲B Q4؛ ۴۸–۹۶GB: ۷۰B Q4، مشروط به کانفیگ |
| PC Land Atlas R3 | 2 × Xeon Platinum 8481C | DDR5 ECC | ۱۶GB GPU: ۸–۱۴B Q4؛ ۲۴–۳۲GB: تا حدود ۳۲B Q4؛ ۴۸–۹۶GB: ۷۰B Q4، مشروط به کانفیگ |
| PC Land Atlas R4 | 2 × Xeon Platinum 8383C | DDR4 ECC | ۱۶GB GPU: ۸–۱۴B Q4؛ ۲۴–۳۲GB: تا حدود ۳۲B Q4؛ ۴۸–۹۶GB: ۷۰B Q4، مشروط به کانفیگ |
| NVIDIA DGX Spark | GB10؛ CPU بیستهستهای Arm | ۱۲۸GB LPDDR5x مشترک؛ SSD 4TB | تا ۲۰۰B طبق اعلام سازنده؛ نیازمند فرمت و نرمافزار مناسب |
Astra و Orion: نمونههایی برای شروع و توسعه
Astra در کاتالوگ با دو Xeon Gold 6150 و Orion با دو Xeon Platinum 8173M ثبت شدهاند؛ هر دو گزینه رم DDR4 ECC و GPU قابل انتخاب دارند. برای دستیار متن و جستوجوی اسناد، میتوان کانفیگ با کارت استاندارد ۱۶GB را همراه مدل ۸B یا ۱۴B چهاربیتی بررسی کرد. اگر هدف Qwen3-32B است، انتخاب GPU با ۲۴ یا ترجیحاً ۳۲GB فضای بیشتری میدهد. رم بیشتر به اسناد و سرویسها کمک میکند، اما یک مدل ۳۲B را بهطور کامل داخل VRAM کارت ۱۶GB جا نمیدهد.
چهار گزینه برای شروع، توسعه و اجرای مدلهای محلی
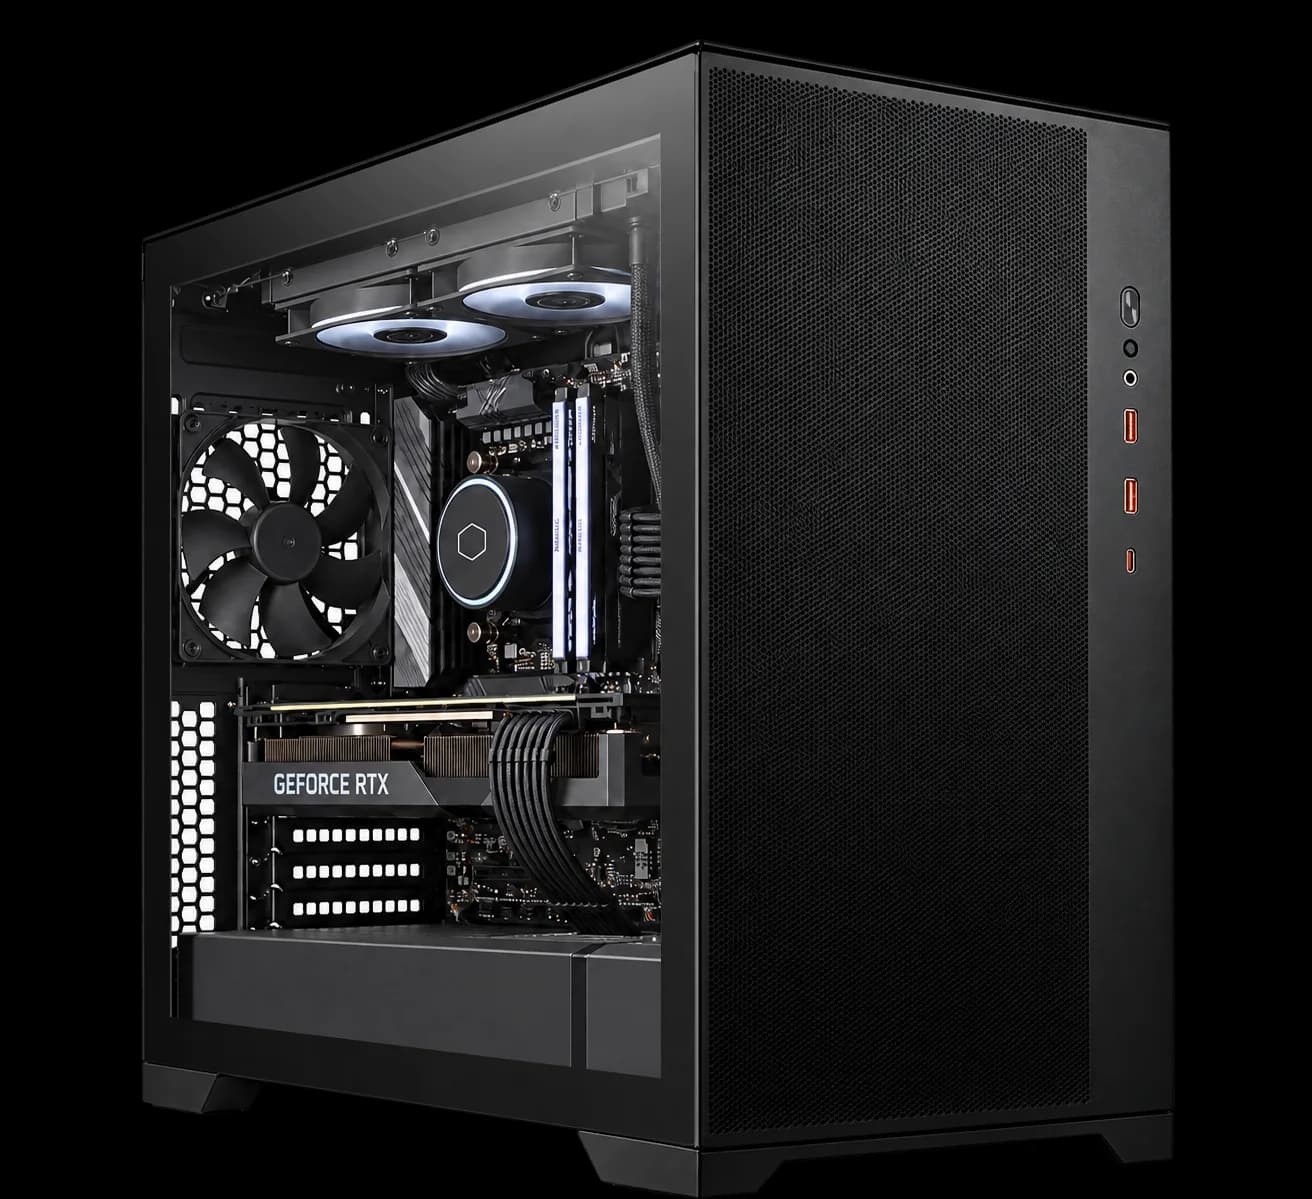
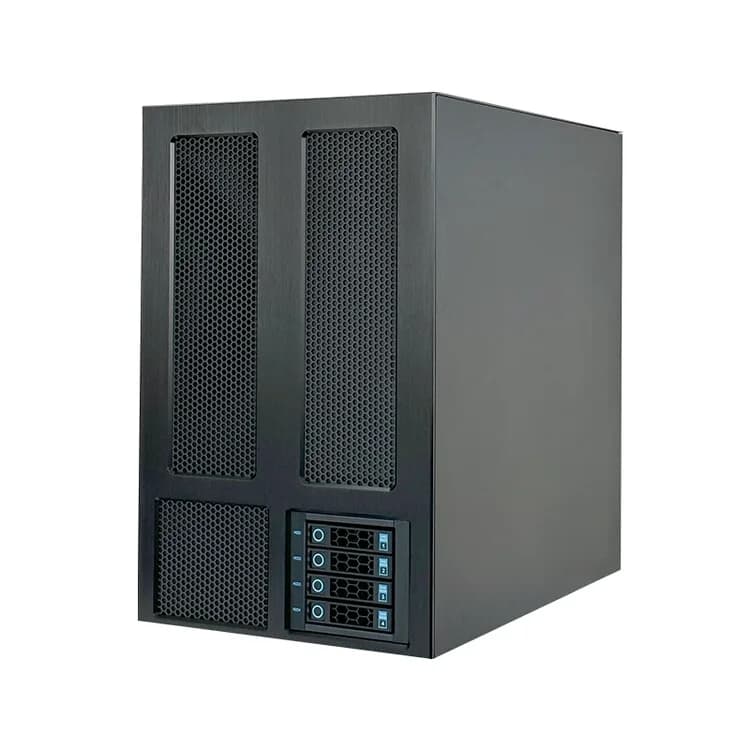
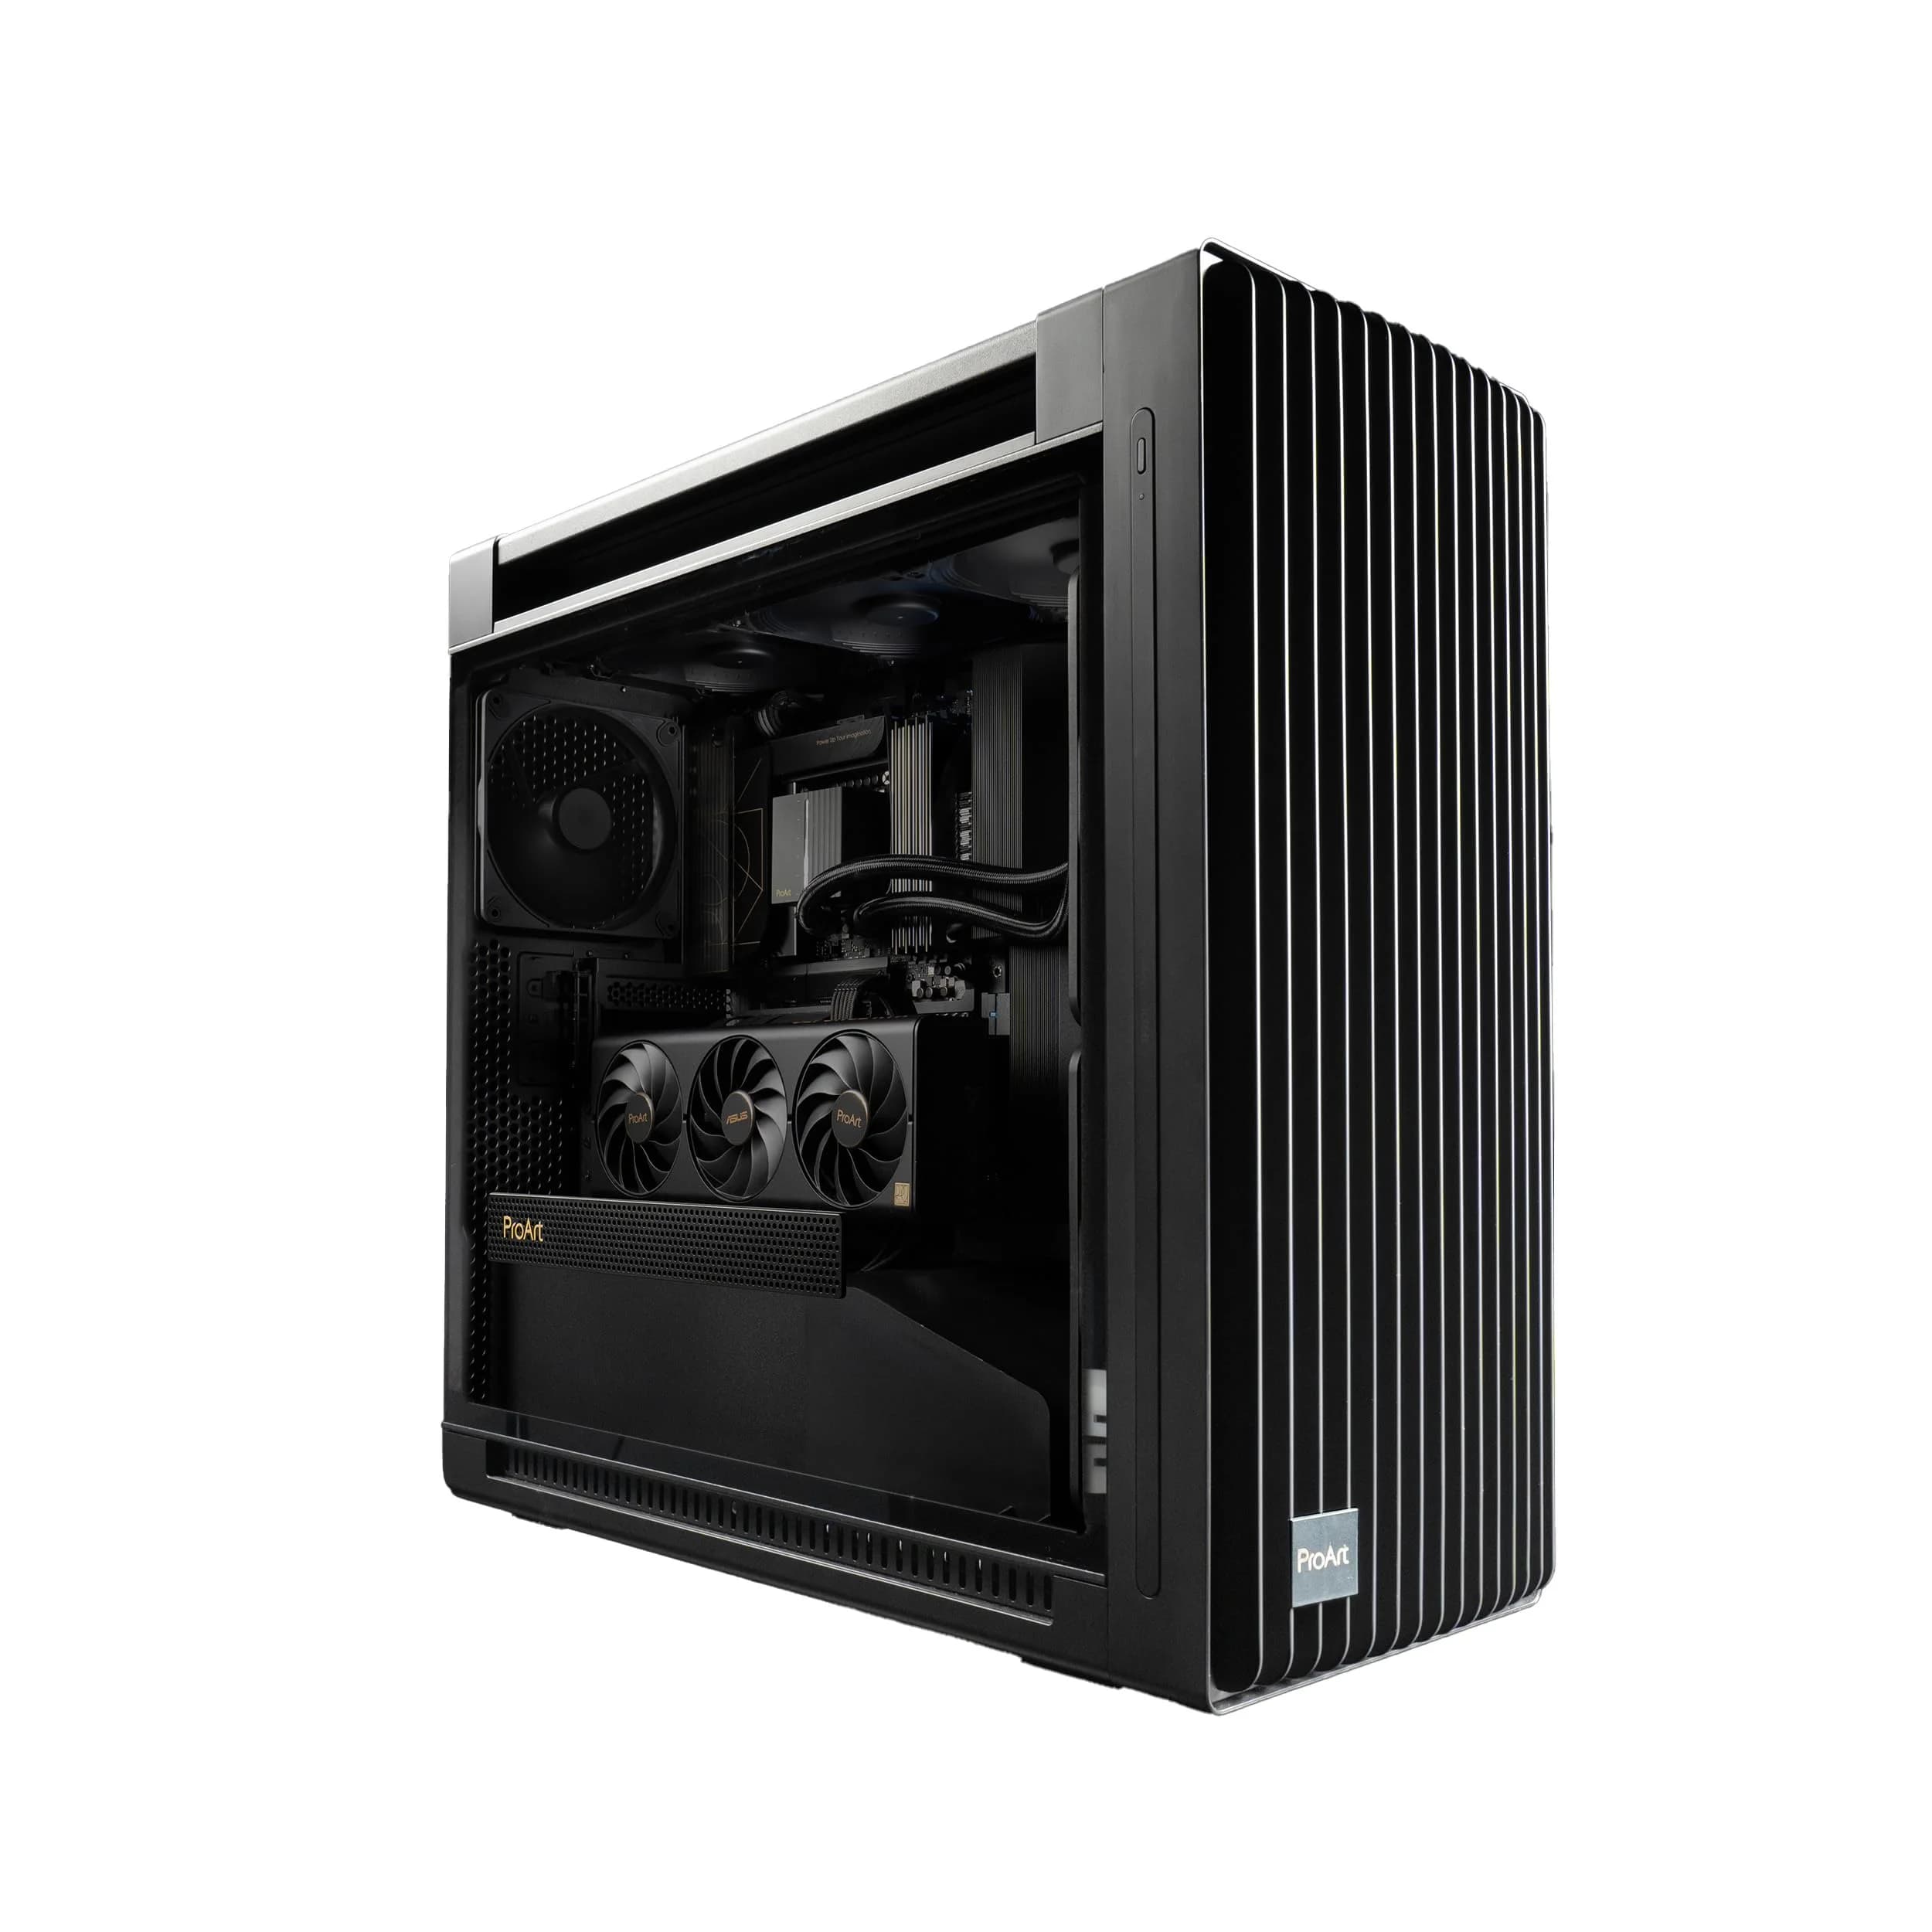
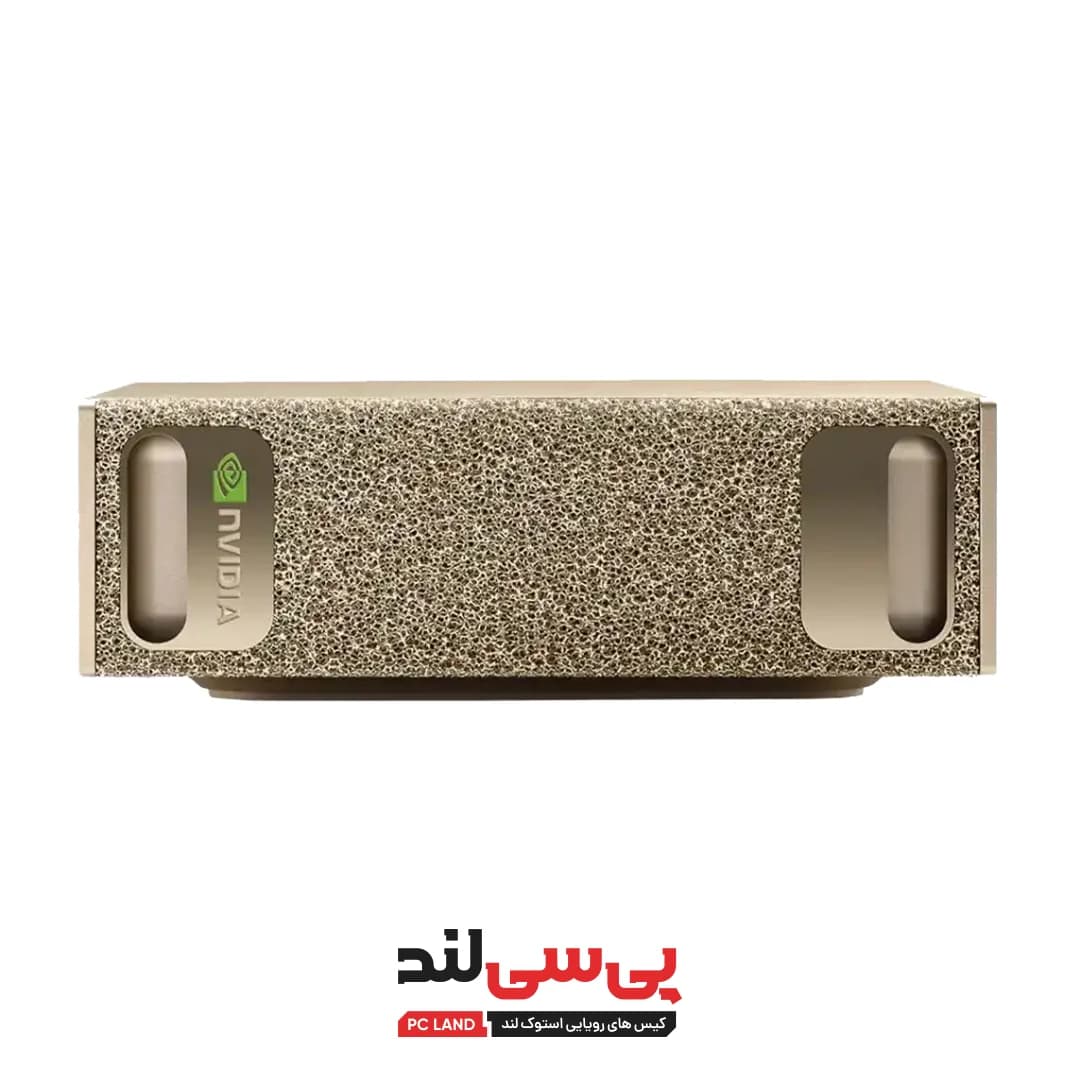
کانفیگ، قیمت و موجودی را در صفحه هر محصول ببینید. در Astra، Orion و PA602 ظرفیت اجرای مدل به GPU انتخابی، فرمت وزن و طول ورودی وابسته است؛ ظرفیت DGX Spark را در بخش اختصاصی آن بررسی کردیم. تصاویر Astra و Orion در کاتالوگ آزمایشی معرفی شدهاند و نمای تأییدشده شاسی نهایی نیستند.
Helios و Atlas: انتخاب فرم دستگاه و پلتفرم میزبان
Helios به شکل Tower معرفی شده و خانواده Atlas در توضیحات کاتالوگ برای استقرار رک مطرح است. T1 و T2 و همچنین R1 و R2 با دو Xeon Platinum 8582C ثبت شدهاند؛ T3 و R3 با دو 8481C و T4 و R4 با دو 8383C. برای پلتفرمهای DDR5 میتوان ظرفیت رم و پردازش داده را بررسی کرد، ولی با GPU یکسان، داشتن نام یا CPU متفاوت سقف حافظه مدل زبانی را بهتنهایی تغییر نمیدهد.
برای مدل ۷۰B چهاربیتی، کانفیگ ۴۸GB ممکن است نقطه شروع باشد؛ ۷۲ تا ۹۶GB فضای بیشتری برای سربار میدهد. این پیشنهاد مشروط به تأیید نصب کارت، خنککاری و موجودی است. تفاوت T1 با T2 یا R1 با R2 را از شماره نام نتیجه نگیرید: تعداد GPU، مادربرد، پاور و چیدمان حافظه نهایی باید در پیشفاکتور ثبت شوند.
HP Z8 G5 و ASUS PA602: بررسی کانفیگ دقیق اهمیت دارد
HP Z8 G5 در کاتالوگ با دو Xeon Platinum 8481C و رم DDR5، و سیستم مبتنی بر ASUS PA602 با دو Xeon Gold 8269CY و رم DDR4 ثبت شدهاند. این مشخصات، اطلاعات فروشگاه درباره کانفیگ عرضهشدهاند. PA602 نام شاسی است و ظرفیت AI را مادربرد، پردازنده، GPU و قطعات نصبشده تعیین میکنند. برای مدل HP نیز پارتنامبر و سازگاری کانفیگ ثبتشده باید بررسی شود؛ نام مدل بهتنهایی تأیید کانفیگ کارخانه نیست.
برای محاسبه ظرفیت، از کارتهایی با حافظه و هویت فنی روشن استفاده کنید. برخی نامهای خاص یا نسخههای تغییریافته در گزینههای فروشگاه، مانند عنوان RTX 4090 با ۴۸GB، را نباید بدون تأیید مشخصات واقعی و سازگاری درایور با کارت استاندارد سازنده یکسان دانست. در پیشنهادهای این مقاله، مبنا ظرفیت مشخص و قابل تأیید است.
چهار پیشنهاد برای پروژههای بزرگتر و استقرار سازمانی
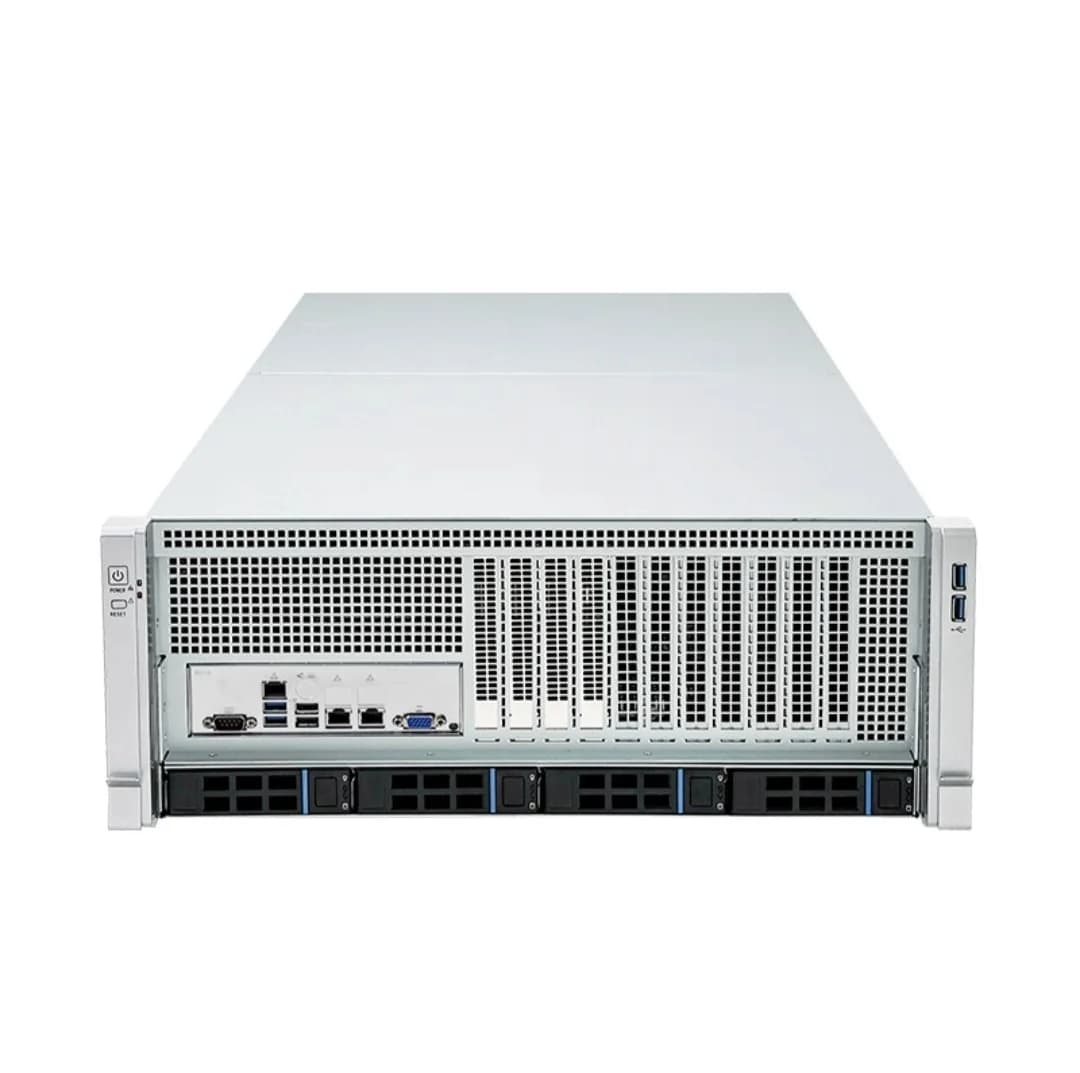
Helios برای فرم تاور و Atlas برای استقرار رک در کاتالوگ معرفی شدهاند. تعداد GPU، سازگاری کارت، توان پاور و خنککاری باید در کانفیگ سفارش تأیید شوند. برای بررسی مدل ۷۰B چهاربیتی، حافظه گرافیکی ۴۸ تا ۹۶GB را با فایل مدل و طول ورودی واقعی آزمایش کنید؛ داشتن این شاسیها بهتنهایی تضمین اجرای ۷۰B نیست.
چطور قدرت واقعی یک سرور AI را قبل از خرید بسنجیم؟
قدرت واقعی فقط از عدد TFLOPS، هسته CPU یا تعداد پارامتر به دست نمیآید. برای تصمیم خرید، یک آزمون با مدل و فایل دقیق شما لازم است. نام GPU، ظرفیت حافظه آزاد، نسخه موتور، نوع Quantization، طول ورودی و تعداد کاربران باید در گزارش آزمون مشخص باشند؛ در غیر این صورت دو عدد سرعت قابل مقایسه نیستند.
- مدل را دقیق نام ببرید: مثلاً Qwen3-32B با فایل Q4_K_M، نه فقط «مدل ۳۲ میلیاردی».
- دو طول ورودی متناسب با کار انتخاب کنید: یک مکالمه کوتاه و یک سند طولانی؛ حجم خروجی را هم یکسان بگیرید.
- زمان تا اولین پاسخ را اندازه بگیرید: کاربر پیش از شروع خروجی چقدر منتظر میماند؟
- سرعت ادامه پاسخ و زمان پایان کار را ثبت کنید: توکنبرثانیه بهتنهایی اثر طول پاسخ و مراحل استدلال را نشان نمیدهد.
- مصرف حافظه و پایداری را بررسی کنید: خطای کمبود حافظه، Offload، دما و افت عملکرد در بار طولانی اهمیت دارند.
- اگر چندکاربره است، آزمون را با تعداد درخواست همزمان موردنظر تکرار کنید؛ عدد کاربر ثابت از ظرفیت VRAM نتیجه نمیشود.
- کیفیت را کنار سرعت بسنجید: پاسخ درست، استناد به سند، پیروی از قالب و نیاز به اصلاح انسانی را ثبت کنید.
برای مقایسه با آنلاین نیز از همان مجموعه پرسش و معیار استفاده کنید. پیشنهاد عملی، ساختن یک مجموعه ۵۰ تا ۱۰۰ نمونه از کارهای روزمره خودتان است: تولید متن فارسی، خلاصه سند، پاسخ مستند، کدنویسی و مواردی که جواب ندارند. بررسی کنید مدل در نبود سند، پاسخ ساختگی میدهد یا محدودیت اطلاعات را بیان میکند. برنده واقعی، سامانهای است که کار موردنظر را با کیفیت، زمان و هزینه پذیرفتنی انجام دهد.
استنتاج، Fine-tuning و آموزش از صفر را یکی نگیرید
استنتاج یعنی استفاده از مدل آماده برای تولید پاسخ. Fine-tuning یعنی تغییر مدل با داده تخصصی؛ روشهای LoRA و QLoRA میتوانند نیاز حافظه را نسبت به تنظیم کامل کمتر کنند. آموزش از صفر مرحلهای بسیار پرهزینهتر است و به دیتاست، زمان و زیرساخت متفاوتی نیاز دارد. سروری که یک مدل ۷۰B چهاربیتی را اجرا میکند، الزاماً توان آموزش کامل همان مدل را ندارد.
نیاز حافظه آموزش علاوه بر وزنها شامل گرادیانها، وضعیت بهینهساز و Activation است. به همین دلیل جدول استنتاج این مقاله برای خرید دستگاه آموزش از صفر کافی نیست. برای بسیاری از کسبوکارها، ابتدا RAG و تنظیم پرامپت منطقیتر است: اگر مشکل، ندانستن اطلاعات تازه شرکت باشد، بازیابی سند میتواند بدون تغییر وزن مدل آن را حل کند.
نرمافزارهای اجرای هوش مصنوعی لوکال
دانلود نرمافزارهای اجرای محلی از منابع رسمی
دانلود LM Studioدریافت برنامه از سایت رسمی؛ نسخه مناسب سیستمعامل و معماری پردازنده را انتخاب کنید.دانلود Ollamaصفحه رسمی دریافت برای Windows، macOS و Linux؛ مدلها را پس از نصب جداگانه دریافت کنید.دریافت نسخههای آماده llama.cppبخش Releases رسمی پروژه؛ بسته سازگار با سیستمعامل، معماری و Backend کارت گرافیک را انتخاب کنید.لینکهای مدل به فهرست فایلهای مخزن رسمی میروند تا فرمت و دقت مناسب را انتخاب کنید؛ لازم نیست همه نسخههای کوانتیزه را دانلود کنید. GGUF با وزنهای Safetensors یا MXFP4 یکسان نیست. برای مخزن چندبخشی، فایل تنظیمات و توکنایزر و تمام بخشهای وزن موردنیاز موتور را هم آماده کنید. دانلود برنامه یا مدل به اینترنت نیاز دارد؛ کار آفلاین بعد از آمادهسازی کامل آغاز میشود.
راهاندازی یک سامانه واقعاً آفلاین، گام به گام
- کاربرد را تعریف کنید: چت، کد، تصویر، صوت یا پاسخ به اسناد؛ زبان، حجم داده و تعداد کاربران را مشخص کنید.
- یک مدل مناسب انتخاب کنید: کارت مدل، مجوز، نسخه و فرمت وزن را بخوانید و فایل لازم را دریافت کنید.
- موتور و درایور سازگار نصب کنید: روی GB10 سازگاری Arm و روی GPU مجزا Backend لازم را بررسی کنید.
- تمام وابستگیها را آماده کنید: توکنایزر، OCR، Embedding، Reranker و اجزای موردنیاز زنجیره باید محلی باشند.
- ابتدا با ورودی کوتاه و یک کاربر اجرا کنید: از طول مکالمه کوچک شروع و مصرف حافظه را ثبت کنید.
- کاربرد سند را با فایل واقعی آزمایش کنید: متن استخراجشده، سند بازیابیشده و پاسخ نهایی را جدا بررسی کنید.
- حالت آفلاین را عملاً امتحان کنید: پس از آمادهسازی، اینترنت خارجی را قطع و یک کار کامل اجرا کنید؛ هر وابستگی پنهان در این مرحله آشکار میشود.
- برای تیم، دسترسی و پشتیبان مشخص کنید: حسابها، مجوز اسناد، نگهداری مکالمه و زمان بهروزرسانی را تعریف کنید.
هزینه خرید سرور AI را چطور با آنلاین مقایسه کنیم؟
برای مقایسه اقتصادی، «هزینه مالکیت» را محاسبه کنید: قیمت دستگاه و ارتقا، نصب، برق، نگهداری، فضای استقرار و زمان نیروی فنی. در سرویس آنلاین نیز هزینه اشتراک یا API، حجم ورودی و خروجی، تعداد درخواست و امکانات لازم را وارد کنید. بهتر است معیار نهایی هزینه هر کار موفق باشد؛ مدلی که ارزان پاسخ میدهد ولی اصلاح زیادی میخواهد، ممکن است در عمل گرانتر شود.
مثال فرضی محاسبه برق: اگر میانگین مصرف اندازهگیریشده یک سیستم ۶۰۰ وات باشد و ماهانه ۲۰۰ ساعت زیر بار کار کند، انرژی این بخش ۱۲۰ کیلوواتساعت است. تعرفه برق، مصرف زمان بیکار و خنککاری را باید جدا اضافه کرد. عدد ۶۰۰ وات در این مثال مشخصات هیچیک از محصولات معرفیشده نیست.
نقطه سربهسر را با دوره زمانی موردنظر حساب کنید: هزینه اولیه را بر صرفهجویی ماهانه واقعی نسبت به سرویس آنلاین تقسیم کنید. اگر دستگاه بیشتر ساعات بیکار بماند، بازگشت سرمایه طولانی میشود. اگر کار پیوسته، داده محرمانه یا هزینه توقف زیاد باشد، ارزش دسترسی مستقل و کنترل داده نیز باید کنار هزینه مالی دیده شود.
اشتباههای رایج در خرید سرور هوش مصنوعی آفلاین
- خرید بر اساس CPU بدون مشخص کردن مدل هدف و VRAM؛ هسته بیشتر بهتنهایی مدل بزرگتر را روی GPU جا نمیدهد.
- یکی دانستن RAM و VRAM؛ حافظه یکپارچه نیز معماری و پهنای باند متفاوتی دارد.
- محاسبه ظرفیت MoE بر پایه پارامتر فعال؛ برای حافظه باید وزن کل مدل را بررسی کرد.
- فرض اینکه مدل بزرگتر همیشه برای فارسی یا کار تخصصی بهتر است؛ ارزیابی نمونه واقعی ضروری است.
- نادیده گرفتن طول ورودی، تصویر و همزمانی؛ هر سه میتوانند فضای لازم را افزایش دهند.
- اشتباه گرفتن توان اسمی FP4 یا FP8 با سرعت واقعی پاسخ؛ عددهای با دقت متفاوت مستقیماً همارز نیستند.
- انتخاب GPU از فهرست گزینهها بدون تأیید ابعاد، توان، تهویه و پشتیبانی نرمافزار.
- مقایسه هزینه API با قیمت دستگاه و حذف برق، نگهداری و نیروی فنی.
برای هر نوع کاربر چه انتخابی منطقیتر است؟
برای یادگیری و دستیار شخصی، از مدل کوچک روی سختافزار موجود شروع کنید؛ اگر کیفیت کافی بود، خرید دستگاه بزرگتر ضرورتی ندارد. برای تیم برنامهنویسی، ابتدا مدل کدنویسی را روی نمونه مخزن خودتان بسنجید و بعد ظرفیت ۲۴ یا ۳۲GB را بررسی کنید. برای شرکت با اسناد داخلی، کیفیت RAG، دسترسی کاربران و حفظ داده در کنار GPU اهمیت دارند.
برای مدلهای بزرگتر و توسعه در اکوسیستم انویدیا، DGX Spark با حافظه یکپارچه قابل بررسی است. برای استقرار داخلی و نیاز به ارتقای قطعات، ورکاستیشن یا سرور قابل پیکربندی را با مدل هدف مقایسه کنید. برای آموزش بزرگ یا سرویسدهی پرحجم، وارد رده تجهیزات دیتاسنتری میشوید و طراحی زیرساخت باید بخشی از پروژه باشد.
پرسشهای متداول درباره هوش مصنوعی لوکال و آفلاین
آیا هوش مصنوعی لوکال بدون اینترنت کار میکند؟
بله، پس از آماده کردن وزن مدل، نرمافزار و همه وابستگیها. جستوجوی وب و ابزارهای خارجی به اینترنت نیاز دارند. برای اطمینان، یک کار کامل را پس از قطع اینترنت آزمایش کنید.
آیا هوش مصنوعی آفلاین از آنلاین قویتر است؟
برتری قطعی در همه کارها ندارد. مزیت اصلی، کنترل داده و استقلال در اجراست. کیفیت پاسخ را مدل، دقت اجرا، ابزارها و داده تعیین میکنند و باید با آزمون یکسان مقایسه شود.
برای مدل ۳۲ میلیاردپارامتری چقدر حافظه لازم است؟
فایل Qwen3-32B در Q4_K_M حدود ۱۹٫۸GB است؛ Cache و سربار به آن اضافه میشوند. کارت ۲۴GB با Context محدود نامزد اجراست و ۳۲GB حاشیه بیشتری دارد. این اعداد به نسخه فایل و موتور وابستهاند.
آیا کارت ۴۸GB مدل ۷۰B را اجرا میکند؟
نسخه چهاربیتی بعضی مدلهای ۷۰B میتواند روی ۴۸GB قابل بررسی باشد، ولی طول ورودی و همزمانی محدودیت ایجاد میکنند. فایل مدل و مصرف واقعی باید پیش از سفارش آزمایش شوند.
DGX Spark واقعاً مدل ۲۰۰B را هندل میکند؟
انویدیا برای نسخه ۱۲۸GB سقف استنتاج تا ۲۰۰ میلیارد پارامتر اعلام میکند. این سقف مشروط به فرمت و تنظیمات مناسب است و وعده اجرای همه مدلهای ۲۰۰B با هر طول ورودی یا سرعت مشخص نیست.
آیا دو GPU حافظهشان خودکار جمع میشود؟
خیر. موتور باید تقسیم مدل را پشتیبانی کند و اتصال، روش تقسیم و سازگاری کارتها بر نتیجه اثر دارند. دو کارت ۲۴GB الزاماً مانند یک کارت ۴۸GB عمل نمیکنند.
آیا روی سرور آفلاین میتوان تصویر و صوت هم پردازش کرد؟
بله، با مدل و نرمافزار مناسب هر کار. مدل تحلیل تصویر با مدل تولید تصویر فرق دارد. تبدیل گفتار به متن و RAG نیز اجزای مستقل دارند که باید محلی نصب شوند.
آیا اجرای مدل با آموزش آن فرق دارد؟
بله. استنتاج از وزن آماده استفاده میکند؛ Fine-tuning و آموزش از صفر علاوه بر وزن به حافظه و محاسبات بیشتری نیاز دارند. ظرفیت استنتاج تضمین ظرفیت آموزش نیست.
آیا محصولات استوکلند با هر کانفیگ مدل ۷۰B را اجرا میکنند؟
خیر. برای محصولات قابل پیکربندی، ظرفیت به GPU، RAM، فایل مدل و Context وابسته است. کانفیگ ۱۶GB را نباید با کانفیگ ۴۸ یا ۹۶GB یکسان در نظر گرفت؛ موجودی پیشسفارش نیز جدا بررسی میشود.
منابع رسمی و روش این بررسی
این راهنما از مشخصات رسمی سازندگان، کارت مدلها و داده فعلی کاتالوگ استوکلند استفاده میکند. اعداد حافظه خام و مثال KV Cache محاسبهشدهاند؛ برای هیچ محصول، نرخ توکنبرثانیه یا تعداد کاربر بدون آزمون اعلام نشده است. تصویر شاخص، تصویر مفهومی تولیدشده با هوش مصنوعی است و نمای دقیق یک کانفیگ قابل فروش نیست. کارتهای محصول، عنوان، تصویر و لینک را از کاتالوگ فعلی میخوانند؛ برخی تصاویر کاتالوگ از جمله Astra و Orion آزمایشیاند و نمای تأییدشده کانفیگ نهایی نیستند.
- Qwen3-32B: مشخصات مدل
- Qwen3-32B-GGUF: حجم فایلهای واقعی
- Qwen3.6-27B
- Qwen3-Coder
- DeepSeek-R1 و نسخههای تقطیرشده
- Llama 3.3
- Mistral Small 3.1
- Microsoft Phi-4
- Gemma 3
- Gemma 4
- gpt-oss
- FLUX.1-schnell
- faster-whisper large-v3
- Qwen3 Embedding
- سختافزار DGX Spark
- کاربرد و سقفهای اعلامی DGX Spark
- DGX Station نسل GB300
- DGX B200
- DGX GB300
- Ollama و حالت فقط محلی
- اجرای آفلاین LM Studio
- llama.cpp

اولین دیدگاه مفید درباره این مطلب را شما بنویسید.