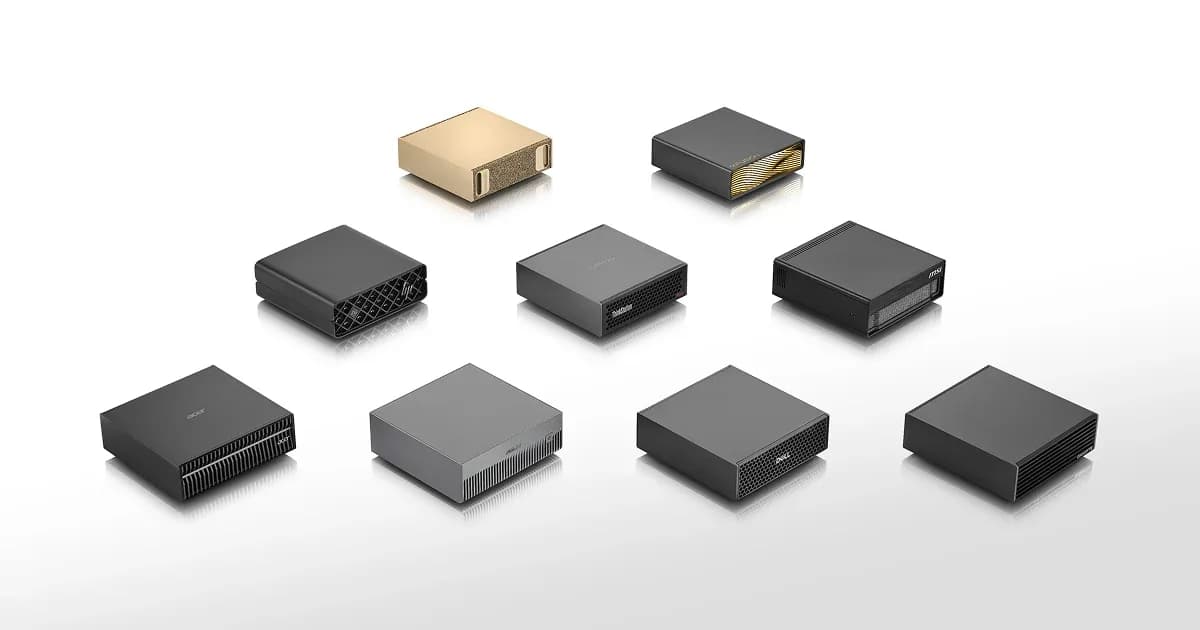
کیس هوش مصنوعی چیست و چرا NVIDIA و AMD سراغ ساخت رایانههای مخصوص AI رفتهاند؟ پاسخ کوتاه این است: این دستگاهها بستری برای اجرای مدلهای هوش مصنوعی روی میز کار شما هستند؛ از دستیار متنی و تولید تصویر تا آزمایش مدلهای اختصاصی سازمان. اما همه آنها یک کلاس سختافزاری ندارند. DGX Spark یک رایانه کوچک برای توسعه و اجرای AI محلی است، DGX Station به بارهای بسیار بزرگتر میپردازد و Ryzen AI Halo راهکار AMD با معماری x86 و حافظه یکپارچه است.
در این راهنما، معنی واقعی این دستگاهها، تفاوت نسلها، کاربردهای عملی و معیارهای انتخاب را بررسی میکنیم. سپس نشان میدهیم چه زمانی یک ورکاستیشن AI قابلپیکربندی از مجموعه پیسیلند و استوکلند برای پروژه شما مناسبتر است. این مقاله بر پایه مشخصات و مستندات رسمی نوشته شده و شامل بنچمارک اختصاصی آزمایشگاه ما نیست. تاریخ بررسی منابع: ۵ اکتبر ۲۰۲۶.
کیس هوش مصنوعی چیست؟ تفاوت AI PC و ورکاستیشن AI
اصطلاح «کیس AI» نام یک استاندارد واحد نیست. گاهی به کامپیوتر دارای NPU گفته میشود، گاهی به سیستم مجهز به GPU قدرتمند و گاهی به یک پلتفرم کامل با نرمافزارهای توسعه ازپیشآماده. بنابراین باید از نام تبلیغاتی عبور کرد و پرسید: این دستگاه دقیقاً کدام مدل را با کدام نرمافزار و چه سرعتی اجرا میکند؟ داشتن عبارت AI در نام دستگاه، پاسخ این پرسش نیست.
- AI PC عمومی: برای قابلیتهای روزمره هوش مصنوعی و برنامههایی که از CPU، GPU یا NPU استفاده میکنند؛ مناسب بودن آن برای مدلهای بزرگ به حافظه و نرمافزار وابسته است.
- رایانه کوچک مخصوص AI: با تمرکز بر اجرای محلی مدلها، حافظه مشترک و محیط توسعه آماده؛ مانند DGX Spark و Ryzen AI Halo.
- ورکاستیشن AI قابلپیکربندی: سیستمی با انتخاب پردازنده، RAM، GPU و SSD متناسب با پروژه؛ برای ترکیب AI، رندر، تحلیل داده و توسعه.
- پلتفرم حرفهای در کلاس DGX Station: برای ظرفیت حافظه و محاسبات بسیار بالاتر، مدیریت سازمانی و پروژههایی فراتر از یک مینیکامپیوتر.
CPU، GPU و NPU هرکدام چه کاری میکنند؟
CPU اجرای سیستمعامل، آمادهسازی داده و بسیاری از کارهای عمومی را بر عهده دارد. GPU بخش بزرگی از محاسبات موازی مدلهای زبانی و تصویری را انجام میدهد. NPU شتابدهندهای مخصوص عملیات هوش مصنوعی است، اما استفاده از آن به پشتیبانی برنامه و مدل وابسته است. NPU پرقدرت به این معنی نیست که هر مدل زبانی، خودکار روی آن اجرا میشود. در انتخاب دستگاه، مسیر اجرای نرمافزار شما باید مشخص باشد.
NVIDIA DGX Spark چیست و چه کاربردی دارد؟
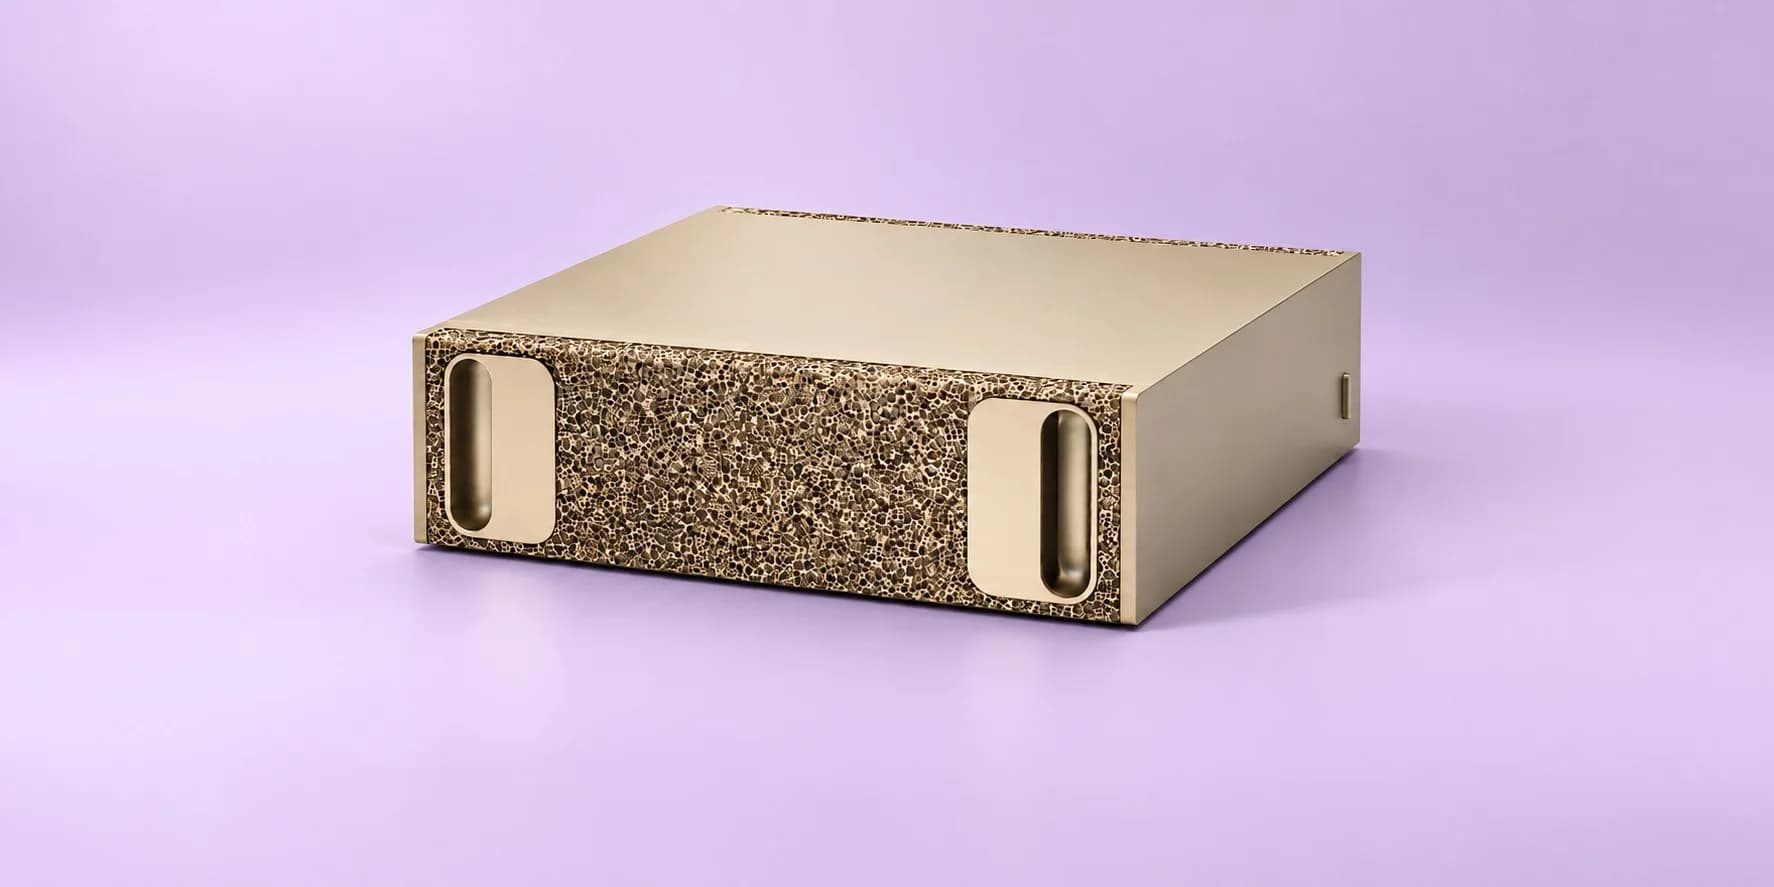
از نظر عملی، Spark برای توسعهدهندهای جذاب است که میخواهد مدل را کنار لپتاپ خود اجرا کند و برای آزمایشهای تکراری به یک محیط محلی دسترسی داشته باشد. پروژه چتبات داخلی، نمونهسازی عامل هوشمند یا بررسی امکان اجرای مدل پیش از انتقال به زیرساخت بزرگتر، از سناریوهای مناسب این کلاس دستگاه است. تصمیم نهایی باید با مدل و کد واقعی شما گرفته شود.
نسخه ۶۴ گیگابایتی و اتصال چند Spark
NVIDIA DGX Station؛ فراتر از یک مینیکیس AI
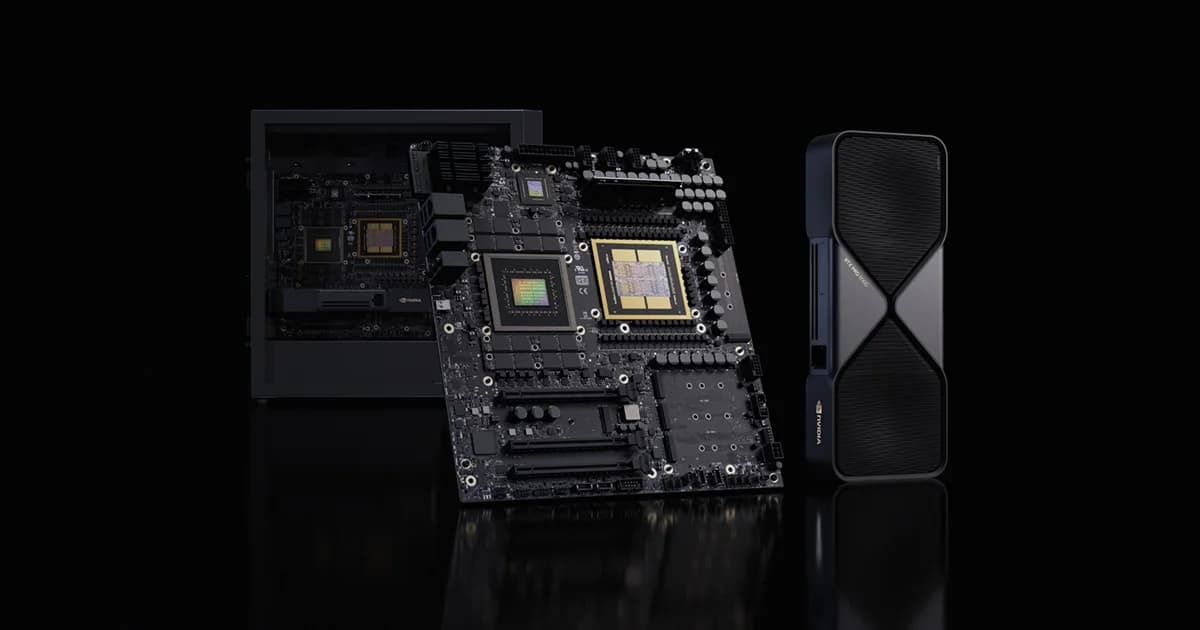
Station را نباید فقط Spark بزرگتر تصور کرد. نوع حافظه GPU، مسیر ارتباط CPU و GPU و امکانات پلتفرم متفاوت است. برای یک تیم پژوهشی که مرتباً به محدودیت حافظه میرسد، این تفاوتها مهماند؛ برای توسعهدهندهای که مدل کوچک اجرا میکند، ممکن است خرید چنین پلتفرمی با نیاز پروژه متناسب نباشد.
AMD Ryzen AI Halo چیست؟ مدل 395 و نسل PRO 495
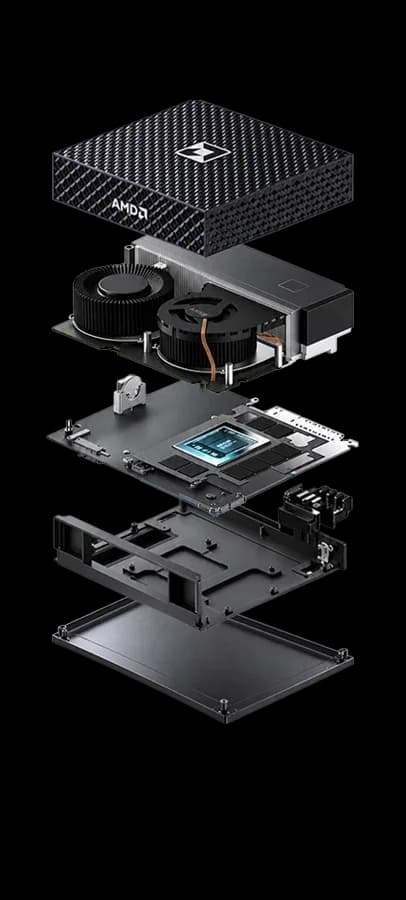
Ryzen AI Halo با Max+ 395
Ryzen AI Halo با Max+ PRO 495
ROCm و محیط توسعه AMD
مقایسه کیس هوش مصنوعی NVIDIA و AMD در یک نگاه
| پلتفرم | معماری و حافظه | تمرکز اصلی | نکته تعیینکننده |
|---|---|---|---|
| DGX Spark 128GB | GB10، CPU از نوع Arm، حافظه یکپارچه ۱۲۸GB | توسعه و اجرای AI محلی | سازگاری Arm و محیط NVIDIA |
| DGX Station GB300 | Grace Blackwell Ultra، مجموع حافظه coherent برابر ۷۴۸GB | بارهای بسیار بزرگتر و کاربرد تیمی | تفکیک حافظه HBM و LPDDR و هزینه زیرساخت |
| Ryzen AI Halo 395 | x86، حافظه یکپارچه ۱۲۸GB | توسعه و استنتاج با ابزارهای سازگار AMD | ROCm و سهم حافظه GPU |
| Ryzen AI Halo PRO 495 | x86، حافظه یکپارچه تا ۱۹۲GB | فضای حافظه بیشتر برای مدلهای محلی | پشتیبانی نرمافزار و کانفیگ دقیق نسل جدید |
| ورکاستیشن AI قابلپیکربندی | وابسته به CPU، RAM و GPU انتخابی | ترکیب AI، تحلیل داده، رندر و توسعه | VRAM، توان برق، خنککاری و امکان ارتقای واقعی |
این جدول مقایسه مشخصات و جایگاه محصولات است؛ رتبهبندی سرعت نیست. برای مقایسه معتبر باید مدل، دقت محاسبات، طول ورودی، طول خروجی، تعداد کاربران و نسخه نرمافزار یکسان باشند. حتی دو دستگاه با حافظه هماندازه ممکن است در پردازش یک سند بلند و تولید پاسخ کوتاه، رفتاری متفاوت از چت کوتاه و پاسخ بلند داشته باشند.
RTX Spark را با DGX Spark اشتباه نگیریم
این دستگاهها چه کاربردهایی دارند؟
۱. اجرای مدل زبانی و دستیار کدنویسی روی سیستم خودتان
در استنتاج یا Inference، یک مدل ازپیشآموزشدیده را اجرا میکنید تا متن تولید کند، کد پیشنهاد بدهد یا یک سند را خلاصه کند. مزیت اجرای محلی، کنترل بیشتر روی فایلها و امکان آزمایش تکراری است. برای مثال، تیم توسعه میتواند دستیار را به مستندات داخلی پروژه متصل کند. کیفیت پاسخ همچنان به مدل، زبان فارسی، داده ورودی و طراحی فرایند وابسته است؛ سختافزار قوی، پاسخ نادرست را خودکار اصلاح نمیکند.
۲. جستوجوی اسناد سازمانی با RAG
در RAG ابتدا اسناد به بخشهای کوچک تبدیل و قابل جستوجو میشوند؛ سپس بخشهای مرتبط همراه پرسش به مدل داده میشوند. این روش برای پاسخگویی درباره قراردادها، دستورالعملها یا راهنمای محصولات کاربرد دارد. RAM، SSD، مدل embedding و پایگاه داده برداری هم در عملکرد نقش دارند. برای ارزیابی، فقط سرعت چت را نسنجید: دقت بازیابی، ارجاع به سند درست و رفتار مدل هنگام نبود پاسخ را هم آزمایش کنید.
۳. تولید تصویر، پردازش ویدئو و گردش کار خلاقه
پروژه تصویری علاوه بر وزن مدل، برای رزولوشن، تعداد فریم، تعداد مراحل و مدلهای جانبی حافظه مصرف میکند. دستگاه مناسب باید گردش کار واقعی شما را اجرا کند؛ مثلاً تولید یک تصویر، اصلاح آن و افزایش اندازه در یک زنجیره واحد. برای ویدئو، ظرفیت حافظه و زمان اجرا حساستر میشود. وجود GPU سازگار با ابزار و افزونهها مهمتر از نام AI روی بدنه است.
۴. فاینتیون و شخصیسازی مدل
Fine-tuning یعنی تطبیق مدل ازپیشآموزشدیده با داده و هدف مشخص. روشهایی مانند LoRA و QLoRA میتوانند نیاز حافظه را در بعضی سناریوها کاهش دهند، اما حافظه لازم فقط وزن مدل نیست: فعالسازیها، داده آموزشی و وضعیت بهینهساز هم نقش دارند. فاینتیون با آموزش کامل یک مدل بسیار بزرگ از صفر تفاوت دارد. برای خرید، اندازه دیتاست، روش آموزش و زمان قابلقبول هر اجرا را مشخص کنید.
۵. عاملهای هوشمند و خدمات داخلی تیم
یک AI Agent ممکن است همزمان مدل را اجرا کند، اسناد را جستوجو کند و با ابزارها کار کند. در نتیجه، دستگاه علاوه بر GPU به CPU، RAM و ذخیرهسازی مناسب نیاز دارد. برای عاملهای همیشه فعال، پایداری بار طولانی، کنترل دسترسی و ثبت فعالیت اهمیت دارند. اجرای محلی کنترل بیشتری فراهم میکند، ولی مجوزهای ابزارها و اتصالات بیرونی همچنان باید در طراحی پروژه مدیریت شوند.
حافظه یکپارچه با VRAM چه فرقی دارد؟
در یک ورکاستیشن دارای کارت گرافیک مجزا، RAM سیستم و VRAM کارت معمولاً دو مخزن جدا هستند. در پلتفرمهای یکپارچه، CPU و GPU میتوانند از ساختار حافظه مشترک استفاده کنند؛ جزئیات این دسترسی به معماری دستگاه وابسته است. مزیت مهم، امکان جا دادن مدلهایی است که از حافظه یک کارت کوچک بزرگترند. با این حال ظرفیت، پهنای باند و تأخیر سه ویژگی متفاوتاند.
برای نمونه، ۱۲۸ گیگابایت RAM در یک تاور معمولی، معادل کارت گرافیک با ۱۲۸ گیگابایت VRAM نیست. انتقال بخشی از مدل به RAM میتواند امکانپذیر باشد، اما میتواند سرعت را کاهش دهد. از سوی دیگر، حافظه یکپارچه زیاد هم لزوماً به معنی سرعت بالاتر از یک GPU مجزای پرقدرت برای مدل کوچکتر نیست. باید ببینید گلوگاه پروژه، ظرفیت حافظه است یا محاسبه و جابهجایی داده.
یک محاسبه ساده برای تخمین حافظه مدل
برای تخمین اولیه وزنها، تعداد پارامترها را در تعداد بیت هر پارامتر ضرب و بر ۸ تقسیم کنید. یک مدل ۷۰ میلیارد پارامتری در نمایش خام ۴بیتی حدود ۳۵ میلیارد بایت وزن دارد. این محاسبه فقط وزنها را تخمین میزند؛ سربار کوانتیزهسازی، حافظه زمان اجرا، سیستمعامل و KV Cache به آن اضافه میشود. بنابراین نمیتوان صرفاً از این عدد، اجرای یک مدل را روی دستگاه تضمین کرد.
KV Cache دادههای میانی موردنیاز پردازش متن را نگه میدارد و با افزایش طول Context و تعداد درخواستهای همزمان رشد میکند. دستگاهی که یک مدل را با ورودی کوتاه اجرا میکند، ممکن است برای همان مدل با اسناد طولانی به محدودیت برسد. اندازه واقعی فایل مدل و اندازهگیری مصرف حافظه در موتور موردنظر، مبنای دقیقتری از تعداد پارامترها هستند.
چرا TOPS و پتافلاپ معیار کافی برای خرید نیستند؟
TOPS تعداد عملیات در ثانیه و FLOPS تعداد عملیات ممیز شناور در ثانیه را بیان میکنند. دقت عددی، تراکم عملیات، قطعه اندازهگیریشده و شرایط محاسبه در معنی عدد نقش دارند. مقایسه ۵۰ TOPS مربوط به NPU با ۱ پتافلاپ FP4 مربوط به GPU، پاسخ مستقیمی درباره سرعت چتبات نمیدهد. حتی مقایسه دو عدد FP4 بدون شرایط یکسان کافی نیست.
- زمان رسیدن به اولین توکن: برای پاسخگویی تعاملی و ورودیهای بلند مهم است.
- سرعت تولید خروجی: تعداد توکن در ثانیه را پس از شروع پاسخ نشان میدهد.
- سرعت پردازش ورودی: برای خلاصهسازی سند و RAG تعیینکننده است.
- عملکرد همزمان: پاسخگویی به چند کاربر را با یک کاربر مقایسه نکنید.
- کیفیت نتیجه: کاهش دقت یا تغییر مدل برای سرعت بیشتر باید از نظر کیفیت هم سنجیده شود.
- پایداری: نتیجه چند دقیقه اول را با اجرای طولانی و تکرارشونده تکمیل کنید.
هوش مصنوعی محلی بهتر است یا سرویس ابری؟
اجرای محلی برای استفاده مستمر، آزمایش روی دادههای داخلی و کنترل نسخه مدل جذاب است. سرویس ابری برای شروع سریع، استفاده مقطعی یا نیاز موقت به منابع بسیار زیاد میتواند مناسب باشد. انتخاب اقتصادی به میزان استفاده واقعی بستگی دارد؛ دستگاه محلی هزینه خرید، برق، نگهداری و زمان مدیریت دارد و استفاده ابری هزینه خدمات و وابستگی به دسترسی شبکه.
یک راه عملی، ترکیب این دو است: نمونهسازی و بخشی از استنتاج روی دستگاه محلی، و کارهای سنگین مقطعی روی زیرساخت بزرگتر. برای تصمیم، چند هفته مصرف واقعی پروژه را برآورد کنید و هزینه کل را بسنجید. حذف هزینه API برای مدلی که محلی اجرا میشود به معنی رایگان شدن همه اجزای پروژه نیست؛ ابزار جانبی یا سرویس متصل ممکن است همچنان هزینه داشته باشد.
چه زمانی ورکاستیشن AI خودمان انتخاب مناسبتری است؟
اگر علاوه بر AI به رندر، ماشین مجازی، پردازش دیتاست یا نرمافزارهای حرفهای نیاز دارید، سیستم قابلپیکربندی ارزش بررسی دارد. میتوانید بودجه را میان GPU، RAM و SSD بر اساس گلوگاه واقعی توزیع کنید. امکان ارتقا را باید برای شاسی، مادربرد و پاور مشخص بررسی کرد؛ عنوان «ورکاستیشن» بهتنهایی تعداد کارتهای قابل نصب یا توان خنککاری را ثابت نمیکند.
- ورکاستیشن AI مدل PC Land Astra: دو Xeon Gold 6150 و بستر DDR4؛ برای بررسی سناریوهای پردازش داده و رندر CPU در کنار GPU منتخب.
- ورکاستیشن PC Land Orion برای پردازش چندوظیفهای: دو Xeon Platinum 8173M، بستر DDR4 و انتخاب مستقل GPU و SSD؛ برای پروژههای ترکیبی و سرویسهای متعدد، پس از بررسی نیاز نرمافزار.
- ورکاستیشن تاور PC Land Helios T1: دو Xeon Platinum 8582C و بستر DDR5؛ برای ارزیابی بارهای حرفهای متکی به CPU و کانفیگ AI سفارشی.
- ورکاستیشن رکمونت PC Land Atlas R1: بر اساس صفحه محصول، دو Xeon Platinum 8582C و DDR5؛ برای تیمهایی که استقرار در رک بخشی از نیازشان است.
در این مدلها GPU، RAM و SSD انتخابیاند؛ بنابراین قیمت پایه یا نام CPU را با توان یک کانفیگ کامل AI برابر نگیرید. ظرفیت نهایی RAM به تعداد ماژولهای نصبشده وابسته است و حافظه کارت گرافیک جداگانه محاسبه میشود. برخی گزینههای GPU پیشسفارش هستند؛ موجودی، مدل دقیق کارت، توان برق و سازگاری نهایی باید هنگام انتخاب بررسی شوند.
CPU دوسوکته، جای GPU مناسب را نمیگیرد
دو پردازنده میتوانند برای کارهای موازی، آمادهسازی داده یا سرویسهای همزمان مفید باشند، اما سرعت همه برنامهها را دو برابر نمیکنند. بعضی بارها بیشتر به توان هر هسته، تأخیر حافظه یا رفتار NUMA حساساند. اگر هدف اصلی شما تولید توکن یا آموزش روی GPU است، اول شتابدهنده و حافظه آن را انتخاب کنید؛ سپس CPU و RAM را برای تغذیه آن متوازن کنید.
راهنمای انتخاب و خرید کیس هوش مصنوعی
- سه گردش کار اصلی را بنویسید: نام مدل، نرمافزار، نوع داده و خروجی موردنیاز.
- حافظه لازم را با مدل واقعی، طول Context و تعداد کاربران بسنجید.
- سازگاری را بررسی کنید: معماری Arm یا x86، سیستمعامل، درایور، فریمورک و افزونهها.
- حداقل سرعت قابلقبول را تعیین کنید: اولین توکن، زمان تصویر یا مدت فاینتیون.
- بار جانبی را حساب کنید: دیتاست، embedding، پایگاه داده، ماشین مجازی و ابزار توسعه.
- فضای ذخیرهسازی را برای مدلها، نسخهها، خروجیها و نسخه پشتیبان برآورد کنید.
- برای کانفیگ دارای GPU مجزا، پاور، کانکتورها، ابعاد کارت و مسیر جریان هوا را کنترل کنید.
- هزینه کامل را مقایسه کنید: قطعات منتخب، نرمافزار لازم، راهاندازی و نگهداری.
- پیش از تصمیم نهایی، یک نمونه از پروژه واقعی را روی کانفیگ پیشنهادی اجرا یا نتیجه قابلتکرار همان کانفیگ را مطالبه کنید.
اشتباههای رایج هنگام انتخاب ورکاستیشن هوش مصنوعی
- خرید بر اساس بزرگترین عدد TOPS یا پتافلاپ بدون توجه به دقت و نرمافزار.
- برابر دانستن حافظه یکپارچه، RAM سیستم و VRAM کارت گرافیک.
- فرض اینکه اجرای مدل ۲۰۰B به معنی آموزش کامل همان مدل یا پاسخ سریع چندکاربره است.
- تعمیم بنچمارک یک مدل با ورودی کوتاه به همه مدلها و اسناد طولانی.
- فرض پشتیبانی یکسان CUDA و ROCm برای همه برنامهها و افزونهها.
- نادیده گرفتن سهم سیستمعامل و KV Cache در مصرف حافظه.
- تلقی قیمت پایه ورکاستیشن بهعنوان قیمت کانفیگ کامل شامل GPU و حافظه موردنیاز.
پرسشهای متداول درباره کیسهای AI انویدیا و ایامدی
آیا این کیسها خودشان هوش مصنوعی دارند؟
آنها سختافزار و محیط اجرای نرمافزارهای AI را فراهم میکنند. برای پاسخگویی یا تولید تصویر باید مدل و برنامه مناسب را نصب یا از مدلهای آماده پلتفرم استفاده کنید. نتیجه به مدل و طراحی پروژه وابسته است.
آیا میتوان مدل زبانی فارسی را آفلاین اجرا کرد؟
پس از دریافت فایلها و آمادهسازی محیط، اجرای مدل سازگار میتواند محلی باشد. کیفیت فارسی به مدل انتخابی وابسته است. ابزارهایی که جستوجوی وب یا API بیرونی دارند همچنان به اینترنت نیاز خواهند داشت.
DGX Spark بهتر است یا Ryzen AI Halo؟
برای همه پروژهها پاسخ واحدی وجود ندارد. محیط نرمافزار، معماری CPU، حافظه قابلاستفاده و عملکرد مدل واقعی شما تعیینکنندهاند. جدول مقاله جایگاه و مشخصات را مقایسه میکند و جای آزمایش یکسان سرعت را نمیگیرد.
حافظه ۱۲۸ گیگابایتی برای هر مدل ۲۰۰ میلیارد پارامتری کافی است؟
خیر. ادعای ظرفیت سازنده وابسته به روش نمایش وزنها و شرایط اجرا است. مدل، کوانتیزهسازی، طول متن و درخواستهای همزمان تعیین میکنند که مدل در حافظه جا شود و با چه سرعتی اجرا شود.
آیا Ryzen AI Halo فقط مدل ۱۲۸ گیگابایتی دارد؟
در منابع رسمی بررسیشده، مدل Max+ 395 با ۱۲۸ گیگابایت و نسل Max+ PRO 495 با حافظه تا ۱۹۲ گیگابایت معرفی شدهاند. مشخصات و تأمین کانفیگ موردنظر باید برای همان مدل بررسی شود.
آیا برای ساخت چتبات داخلی حتماً باید DGX Station خرید؟
خیر. ابتدا مدل، تعداد کاربران، طول اسناد و سرعت لازم را مشخص کنید. یک پلتفرم کوچک AI یا ورکاستیشن با GPU مناسب ممکن است نیاز پروژه را پوشش دهد؛ پروژه بزرگتر به ارزیابی منابع بیشتری نیاز دارد.
آیا ورکاستیشن قابلپیکربندی جایگزین این دستگاهها میشود؟
در بعضی گردش کارها بله، اما معماری حافظه و نرمافزار متفاوت است. انتخاب باید بر اساس مدل و برنامه واقعی باشد. RAM زیاد در ورکاستیشن بهتنهایی جای VRAM کافی یا سازگاری GPU را نمیگیرد.
انتخاب نهایی را از پروژه شروع کنید
DGX Spark، DGX Station و Ryzen AI Halo نشان میدهند اجرای AI روی میز کار به گزینهای جدی برای توسعهدهندگان و تیمها تبدیل شده است. مزیت دستگاه کوچک، تمرکز بر محیط محلی و حافظه مشترک است؛ مزیت ورکاستیشن قابلپیکربندی، انتخاب قطعات برای مجموعه نیازهای پروژه است. بهترین خرید دستگاهی است که گردش کار شما را با کیفیت، سرعت و هزینه قابلقبول اجرا کند.
منابع رسمی و روش بررسی
این راهنما از مشخصات سازندگان و راهنماهای فنی استفاده میکند. اعداد «تا» سقف اعلامشده سازندهاند؛ توصیههای انتخاب، تحلیل تحریریه بر پایه تفاوت معماری و نیاز پروژه هستند. منابع در ۵ اکتبر ۲۰۲۶ بررسی شدهاند:
- NVIDIA DGX Spark؛ محصول و مشخصات
- راهنمای سختافزار DGX Spark
- NVIDIA DGX Station؛ محصول و مشخصات
- دیتاشیت DGX Station
- AMD Ryzen AI Halo؛ معرفی نسلها
- مشخصات AMD Halo 395
- مشخصات AMD Halo PRO 495
- راهنمای رسمی AMD Halo
- اعلام رسمی RTX Spark
حقوق تصاویر داخل مقاله متعلق به NVIDIA و AMD است؛ تصاویر رسمی برای معرفی و مقایسه محصولات با ذکر منبع استفاده شدهاند.
اولین دیدگاه مفید درباره این مطلب را شما بنویسید.