برای ساخت ویدیو با هوش مصنوعی یک انتخاب ثابت برای همه وجود ندارد. برای یک تبلیغ واقعگرایانه همراه صدا، Veo 3.1، Kling 3.0 و Seedance 2.5 در فهرست بررسی قرار میگیرند. برای اجرای لوکال، خانواده LTX و Wan گزینههای مهمیاند. اگر هم خروجی فارسی میخواهید، بهتر است کیفیت تصویر، تلفظ و لبخوانی را جدا بسنجید؛ مدلی که تصویر خوبی میسازد، الزاماً فارسی را روان نمیگوید.
در این راهنما از انتخاب مدل شروع میکنیم، ابزارهای آنلاین مثل هیگزفیلد را میشناسیم و بعد سراغ مدلهای قابل دانلود از هاجینگ فیس، راهاندازی لوکال و انتخاب سیستم میرویم. هدف این است که با چند انتخاب روشن به نتیجه برسید، بدون اینکه بین دهها اسم و اشتراک سردرگم شوید.
راهنمای سریع؛ برای ویدیوی شما کدام مدل مناسبتر است؟
| نوع پروژه | گزینههای پیشنهادی برای شروع مقایسه | روش کار مناسب |
|---|---|---|
| تبلیغ واقعگرایانه با صدای محیط و دیالوگ | Veo 3.1، Kling 3.0، Seedance 2.5 | یک شات کوتاه با تصویر مرجع و صدای مشخص |
| تبلیغ محصول و حرکت دوربین | Kling 3.0، Runway Gen-4.5، Seedance 2.5 | عکس واقعی محصول ← ویدیو؛ لوگو و نوشته در تدوین |
| انیمیشن سهبعدی، کارتونی و انیمه | Seedance، Ray3.14، Wan2.2 | ابتدا طراحی شخصیت، سپس متحرککردن همان تصویر |
| تولید لوکال همراه صدا | LTX-2.5؛ MiniMax H3-Base برای تیم فنی | قالب سازگار، GPU کافی و بررسی مجوز |
| شروع اقتصادی با مدل لوکال | Wan2.2 TI2V-5B | ComfyUI و کلیپ کوتاه با تنظیمات سبک |
| گوینده یا شخصیت فارسیزبان | صدای ضبطشده یا TTS فارسی + ابزار لبخوانی | تأیید صدا پیش از ساخت حرکت دهان |
| ساخت سریع چند نسخه آنلاین | Higgsfield، Pika و سرویسهای چندمدلی | مقایسه روی یک سناریوی ثابت، سپس انتخاب خروجی |
این جدول پیشنهاد نقطه شروع است، نه رتبهبندی قطعی کیفیت. نور، عکس ورودی، پیچیدگی حرکت و تعداد دفعات تلاش میتوانند نتیجه را کاملاً عوض کنند. برای انتخاب نهایی، نمونهای از پروژه خودتان بسازید؛ نمایش تبلیغاتی سایت سازنده بهتنهایی کافی نیست.
فرق مدل، ابزار آنلاین و اجرای آفلاین چیست؟
مدل موتور تولید است؛ مثل Veo، Kling یا Wan. پلتفرم محیطی است که آن موتور را در اختیار شما میگذارد؛ مثل Higgsfield یا Runway. بنابراین همه مدلهای داخل هیگزفیلد، ساخته خود هیگزفیلد نیستند. دو سایت هم ممکن است یک مدل را ارائه دهند، ولی محدودیت زمان، کیفیت خروجی، تعداد مرجع و هزینه متفاوتی داشته باشند.
هاجینگ فیس یا Hugging Face هم یک مدل واحد نیست؛ محل انتشار مدلها و دموهاست. وجود یک Space آنلاین به معنی اجرای آفلاین نیست. برای کار لوکال باید وزن مدل، کد اجرا و اجزای لازم قابل دریافت باشند. بعد از نصب و دانلود کامل میتوانید بدون ارسال فایل به سرویس ابری کار کنید؛ به شرطی که قالب انتخابی از API، نود ابری یا بهبوددهنده پرامپت آنلاین استفاده نکند.
| مسیر | مزیت اصلی | هزینه و محدودیت |
|---|---|---|
| آنلاین | شروع سریع و دسترسی آسان به چند مدل | اشتراک یا اعتبار، صف پردازش و شرایط سرویس |
| لوکال | کنترل بیشتر روی فایلها، نسخه و روند تولید | خرید سختافزار، نصب، برق و نگهداری |
| ترکیبی | لپتاپ برای کار روزانه، سرور برای تولید | نیاز به انتقال فایل و مدیریت دسترسی |
مقایسه مدلهای آنلاین ساخت ویدیو و تولید صدا
در جدول زیر «صدای همزمان» یعنی مدل در روند تولید ویدیو، صدا هم میسازد. اضافهکردن موسیقی یا افکت به ویدیوی آماده، قابلیت متفاوتی است. در سرویسهای چندمدلی حتماً نام مدل و گزینه Audio را در همان صفحه تولید بررسی کنید.
| مدل یا ابزار | کاربرد پیشنهادی | وضعیت صدا | نکته برای فارسی |
|---|---|---|---|
| Veo 3.1 | شات سینمایی، تبلیغ و فضای واقعگرایانه | تولید بومی صدا همراه ویدیو | روانی فارسی را با نمونه کوتاه بسنجید؛ تضمین نشود |
| Kling VIDEO 3.0 | حرکت شخصیت، تبلیغ محصول و چند شات | صدای بومی در حالت پشتیبانیشده | فارسی در فهرست پنج زبان اعلامشده این نسخه نیست |
| Seedance 2.5 / 2.0 | روایت، چند مرجع و هماهنگی تصویر و صدا | تولید مشترک صدا و تصویر | پشتیبانی کلی چندزبانه، معادل تضمین تلفظ فارسی نیست |
| Runway Gen-4.5 | کنترل حرکت و تصویرسازی با متن یا عکس | در راهنمای این مدل، صدای بومی تأیید نشده | صدا یا اجرای بازیگر را در مرحله جدا مدیریت کنید |
| MiniMax H3 | ورودی چندرسانهای و ویدیوی همراه صدا | صدای استریوی بومی | فارسی جزو ۱۱ زبان با پشتیبانی پایدار اعلامشده نیست |
| Grok Imagine Video 1.5 | تولید سریع، تصویر به ویدیو و مرجع صوتی | صدا و گفتار لبخوانیشده | قبل از سفارش جدی، تلفظ و لهجه را بررسی کنید |
| Luma Ray3.14 | استایل کارتونی، انیمه و ویرایش ویدیو | صدای بومی ندارد؛ Add Audio جداست | مناسب تصویر با صدای فارسی جداگانه |
| Adobe Firefly Video | ویدیوهای مکمل و روند تدوین Adobe | تولید افکت صوتی، مرحله جداست | ابزار افکت صوتی جای گوینده فارسی نیست |
| Pika | تولید اجتماعی و ابزارهای متمرکز تصویری و صوتی | بسته به مدل و اپ؛ همه قابلیتها یک مدل نیستند | مدل تصویر و ابزار گفتار را جدا بررسی کنید |
Veo 3.1؛ وقتی تصویر و صدای صحنه را با هم میخواهید
Veo 3.1 در مستندات گوگل، ویدیو را همراه صدای تولیدشده ارائه میکند. برای صحنهای مثل قدمزدن در خیابان بارانی، هم تصویر و هم صدای باران و محیط را در توضیح بنویسید. برای دیالوگ، گوینده و جمله را روشن مشخص کنید و شات را شلوغ نکنید. گزینه خوبی برای ورود به مقایسه ویدیوهای واقعگرایانه است، اما جزئیات دست، برخورد اشیا و تلفظ همچنان نیاز به بازبینی دارند. امکانات نسخه Fast، حالتهای مرجع و خروجی در هر رابط یکسان نیست. راهنمای رسمی Veo مرجع بررسی نسخه و محدودیتهاست.
Kling 3.0؛ برای حرکت، شخصیت و تبلیغ محصول
اگر مسئله شما حرکت بدن، حرکت دوربین یا ساخت چند شات است، Kling 3.0 را در کنار گزینههای دیگر امتحان کنید. عکس مرجع مناسب کمک میکند ظاهر محصول یا شخصیت را بهتر کنترل کنید. راهنمای رسمی VIDEO 3.0 تولید صدا و زبانهای چینی، انگلیسی، ژاپنی، کرهای و اسپانیایی را توضیح میدهد؛ فارسی در این فهرست نیست. بنابراین برای تیزر فارسی، انتخاب تصویر با Kling و ساخت صدای جداگانه مسیر قابلکنترلتری است. پشتیبانی از صدا را به نسخههای قدیمیتر تعمیم ندهید. راهنمای VIDEO 3.0
Seedance 2.5؛ روایت طولانیتر و کنترل با مرجع
Seedance 2.5 نسل جدیدتر این خانواده است و سازنده برای آن تولید کلیپهای صوتیتصویری تا ۳۰ ثانیه و امکان ادامهدادن را معرفی کرده است. نسخه 2.0 هم ورودی متن، عکس، صدا و ویدیو را میپذیرد. این خانواده برای داستان کوتاه، چند شات مرتبط و استفاده از مرجع ارزش بررسی دارد. بااینحال برای شروع، یک کلیپ کوتاه بسازید؛ خطای شخصیت یا حرکت را در شات کوتاه راحتتر اصلاح میکنید. کیفیت گفتار فارسی باید جدا ارزیابی شود و از عبارت «چندزبانه» نمیتوان لهجه طبیعی فارسی را نتیجه گرفت. صفحه رسمی Seedance 2.5

Runway، Luma، Firefly، Pika و Grok؛ انتخاب بر اساس روند کار
Runway Gen-4.5 برای تولید با متن و عکس و توصیف حرکت دوربین قابل بررسی است. ابزارهای دیگری مثل Act-Two یا مدلهای صوتی داخل Runway را با قابلیت خود Gen-4.5 یکی نگیرید. اگر اجرای چهره اهمیت دارد، روند انتقال اجرا را هم جدا بررسی کنید.
Luma Ray3.14 برای حفظ استایلهای دوبعدی، کارتونی و انیمه و تغییر ویدیوی ورودی جالب است؛ صدای آن از مسیر Add Audio اضافه میشود. Firefly هم میتواند در روند کاری Adobe مفید باشد؛ تولید افکت صوتی آن گفتار یا موسیقی تولید نمیکند. در Pika جدید، مدلها و اپهای مختلف تصویر، ویدیو و صدا کنار هم قرار گرفتهاند؛ اسم پلتفرم را جای اسم مدل انتخابشده ننویسید.
Grok Imagine Video 1.5 در مستندات رسمی، تولید ویدیو همراه صدا و گفتار هماهنگ با لب را دارد و برای مقایسه سرعت و نتیجه کوتاه مناسب بررسی است. پشتیبانی از مرجع صوتی هم به معنی تضمین فارسی روان نیست.
Sora 2 در مهر ۱۴۰۵ چه وضعیتی دارد؟
Sora 2 از مدلهای شناختهشده تولید ویدیو و صدا بود، اما برای شروع پروژه جدید، آن را گزینه فعال فرض نکنید. طبق اطلاعیه رسمی OpenAI، وب و اپ Sora در ۲۶ آوریل ۲۰۲۶ متوقف شدهاند و پایان API برای ۲۴ سپتامبر ۲۰۲۶ اعلام شده است. باقیماندن صفحه معرفی یا نام Sora در یک پلتفرم واسط، تأیید دسترسی عملی امروز نیست.
هیگزفیلد چیست و کدام مدل آن را انتخاب کنیم؟
Higgsfield یا هیگزفیلد یک محیط چندمدلی است. مزیتش این است که میتوانید برای یک پروژه، چند موتور تولید را در یک محیط بررسی کنید. بخش Cinema Studio هم انتخاب دوربین و لنز مجازی و کنترل حرکت را در اختیار کاربر میگذارد. این کنترلها کمک به هدایت ظاهر تصویرند؛ جای تضمین فیزیک واقعی یا اجرای بیخطای هر حرکت را نمیگیرند.
برای تبلیغ همراه صدا، Veo یا Seedance را بررسی کنید؛ برای حرکت و عکس محصول Kling را هم وارد مقایسه کنید. افکتهای آماده و حرکتهای نمایشی برای ریلز مفیدند، ولی برای نمایش دقیق محصول، حرکت سادهتر معمولاً بررسی و اصلاح آسانتری دارد. فهرست مدلها و دسترسی هر پلن تغییر میکند؛ پیش از خرید، همان مدل و کیفیتی را که نیاز دارید در حساب بررسی کنید.

مدلهای لوکال ساخت ویدیو در هاجینگ فیس
برای دانلود، از حساب رسمی سازنده شروع کنید. فایل سبکشده یا مدل تغییرکرده جامعه کاربری ممکن است مفید باشد، اما نتیجه و نیاز سختافزاری آن لزوماً با نسخه اصلی یکی نیست. «وزن قابل دانلود» هم همیشه به معنی مجوز آزاد و بدون شرط برای هر کاربرد تجاری نیست.
| مدل لوکال | مناسب برای | صدا | نکته اجرای واقعی |
|---|---|---|---|
| LTX-2.5 / LTX-2.3 | تولید صوتیتصویری، نمونهسازی و روند قابلسفارشیسازی | تولید مشترک صدا و ویدیو | نسخه قالب، وزنها و مجوز باید هماهنگ باشند |
| Wan2.2 TI2V-5B | شروع لوکال با متن یا عکس | بدون تولید بومی صدا در این نسخه | قالب ComfyUI با offload سبکتر از اجرای مرجع است |
| Wan2.2 T2V / I2V A14B | کنترل استایل و پروژههای سنگینتر | در این نسخهها صدا جداست | فایلها و نیاز حافظه با 5B فرق دارند |
| HunyuanVideo-1.5 | تولید متن/عکس به ویدیو با وزن قابل دانلود | در نسخه پایه مورد بررسی، تولید صدای مشترک تأیید نشده | حداقل اعلامی ۱۴GB با offload، نه تضمین سرعت |
| Wan2.2-S2V-14B | شخصیت سخنگو بر اساس صدای ورودی | صدا ورودی است؛ TTS نیست | برای فارسی ابتدا فایل صوتی درست آماده کنید |
| MiniMax H3-Base | تولید مشترک صدا و ویدیو برای تیم فنی | صدای استریوی بومی | همه اجزای روند کامل آنلاین، محلی منتشر نشدهاند |
LTX؛ گزینه مهم برای تولید همزمان صدا و تصویر روی سیستم خودتان
LTX-2.5 وزن قابل دانلود، تولید صدای هماهنگ با تصویر و امکان ساخت چند شات مرتبط را ارائه میکند. LTX-2.3 هم برای قالبها و پروژههای موجود همچنان مهم است. نسخه distilled برای روند سریعتر طراحی شده؛ نسخه dev برای کنترل و آموزش بیشتر کاربرد دارد. این تفاوت به معنی یکسانبودن نتیجه آنها نیست.
برای شروع از قالب رسمی سازگار استفاده کنید. فایلهای text encoder، مدل ویدیویی و بخش صوت را از دو نسخه مختلف ترکیب نکنید. مجوز LTX شرایط تجاری مشخص دارد؛ قبل از استفاده سازمانی متن همان نسخه را بخوانید. برای گفتار فارسی هم پشتیبانی تولید صدا را معادل تلفظ تضمینشده ندانید.
برای دریافت فایلهای LTX-2.5 از هاجینگ فیس، ابتدا وارد حساب شوید و شرایط دسترسی را بخوانید. صفحه رسمی هنگام این بررسی، پذیرش اشتراک اطلاعات تماس را هم پیش از دسترسی به مدل درخواست میکند. این مرحله با نصب مدل و اجرای لوکال متفاوت است.

Wan2.2؛ مسیر مناسب برای یادگیری و تولید بدون صدای بومی
Wan2.2 TI2V-5B هم متن و هم عکس را به ویدیو تبدیل میکند. نسخههای A14B برای متن یا تصویر، فایلها و روند متفاوتی دارند. مدل 5B در اجرای مرجع با offload روی GPU دارای حداقل ۲۴GB VRAM معرفی شده؛ مستندات ComfyUI برای قالب بومی و offload، امکان جاگرفتن آن در ۸GB را هم ذکر میکنند. این دو عدد مربوط به دو روش اجرا هستند و تناقضی ندارند. offload یعنی بخشی از داده بین RAM و GPU جابهجا میشود؛ حافظه کمتر مصرف میشود، ولی زمان تولید میتواند بیشتر شود.

HunyuanVideo-1.5؛ گزینه دیگری برای مقایسه خروجی لوکال
این مدل ۸.۳ میلیارد پارامتری، مسیرهای متن به ویدیو و تصویر به ویدیو دارد. سازنده حداقل ۱۴GB حافظه GPU را با فعالبودن offload اعلام کرده است. این عدد را حداقل شرایط آن روش اجرا بدانید، نه قول تولید سریع در هر وضوح و طول ویدیو. برای تصمیم، یک عکس و یک حرکت یکسان را با Wan و Hunyuan امتحان کنید و زمان، ثبات چهره و جزئیات را کنار هم بگذارید.
MiniMax H3؛ لوکال همراه صدا، با چند تفاوت مهم
MiniMax H3 مدل تولید ویدیو با صدای استریو و ورودیهای چندرسانهای است. بخش H3-Base برای اجرای محلی ارائه شده، اما در مستندات فعلی، بخش Context-IR و مرحله Regenerate-2K کامل بهصورت محلی منتشر نشدهاند. پس دریافت وزن پایه به معنی بازسازی آفلاین تمام امکانات سرویس آنلاین نیست. برای استودیوی فنی ارزش بررسی دارد؛ برای اولین تجربه لوکال، مسیر سادهتری انتخاب کنید. فارسی در فهرست ۱۱ زبان با پشتیبانی پایدار اعلامشده آن نیست و مجوز جامعه H3 هم شرایط خاص خود را دارد.
برای ویدیوی فارسی کدام روش گفتار طبیعیتری میدهد؟
برای فارسی، مسیر پیشنهادی ما ساخت صدای تأییدشده و سپس هماهنگکردن تصویر با آن است. بدون آزمون یکسان و شنیدن خروجیها نمیشود یک مدل ویدیویی را «طبیعیترین گوینده فارسی» نامید. کیفیت به خود جمله، صدا، لهجه، سرعت حرفزدن و حتی اسم برند بستگی دارد.
سه موضوع را جدا کنید: مدل ممکن است پرامپت فارسی را بفهمد، ممکن است فارسی حرف بزند و ممکن است حرکت لب مناسبی بسازد. موفقیت در یکی، دو مورد دیگر را تضمین نمیکند. برای کلیپ بدون شخصیت سخنگو، صداگذاری فارسی روی تصویر سادهترین راه است. برای مجری رو به دوربین، از ابزار صوتمحور یا لبخوانی استفاده کنید.
| روش | میزان کنترل شما | پیشنهاد کاربردی |
|---|---|---|
| گوینده واقعی یا صدای خودتان | کنترل مستقیم لهجه، مکث و تلفظ | برای متن حساس و هویت صوتی برند |
| TTS با پشتیبانی اعلامشده فارسی | امکان بازتولید جمله و تغییر صدا | چند صدا را با یک متن یکسان گوش کنید |
| دیالوگ مستقیم داخل مدل ویدیویی | هماهنگی خودکار، کنترل کمتر روی تلفظ | برای آزمایش کوتاه؛ بعد از تأیید، تولید اصلی |
| صدای آماده + مدل صوتمحور | تأیید صوت پیش از ساخت تصویر | برای شخصیت سخنگو و اصلاح آسانتر جمله |
ElevenLabs در فهرست رسمی Eleven v3، فارسی را ذکر کرده است؛ بنابراین گزینهای برای آزمون TTS فارسی است، نه تضمین بهترین لهجه در تمام جملهها. مدل صوتی انتخابشده مهم است و قابلیت یک نسخه را به همه نسخهها تعمیم ندهید. برای مسیر لوکال، Wan2.2-S2V-14B تصویر و صدای آماده را مبنای ساخت ویدیو قرار میدهد؛ خودش متن فارسی را به گفتار تبدیل نمیکند.
یک تست کوتاه برای انتخاب صدای فارسی
این جمله را با صداهای مختلف امتحان کنید: «سلام! امروز میخوایم ببینیم چطور میشه با هوش مصنوعی، یه ویدیوی طبیعی ساخت. مدل مناسب رو انتخاب کن و قبل از خروجی نهایی، صدا رو یک بار گوش بده.» بعد یک جمله واقعی شامل نام برند، عدد و واژه تخصصی خودتان اضافه کنید.
به تلفظ «خ» و «ق»، آهنگ سؤال، مکث میان جملهها، خواندن عدد و اسم انگلیسی گوش کنید. متن محاورهای را همانطور بنویسید که باید شنیده شود؛ اگر جمله باید «میخوایم» خوانده شود، نوشتن «میخواهیم» لحن را عوض میکند. برای لبخوانی، نمای روبهرو یا سهرخ ملایم و دهان واضح معمولاً نقطه شروع قابلکنترلتری است. ضبط صدا را تمیز و بدون موسیقی زمینه انجام دهید و موسیقی را بعداً اضافه کنید.
آموزش ساخت اولین ویدیو؛ از ایده تا خروجی
- یک هدف مشخص انتخاب کنید: معرفی محصول، نمای سینمایی، انیمیشن یا مجری سخنگو. مدت و نسبت تصویر را از ابتدا تعیین کنید.
- سناریو را به شاتهای کوتاه تقسیم کنید. برای هر شات یک حرکت اصلی و یک نقطه توجه داشته باشید.
- اگر ظاهر محصول یا شخصیت مهم است، یک تصویر مرجع تمیز آماده کنید. برای کالا از عکس همان مدل واقعی استفاده کنید.
- دو یا سه مدل را با ورودی مشابه مقایسه کنید. ابتدا کیفیت آزمایشی بگیرید و فقط شات منتخب را با تنظیمات نهایی بسازید.
- برای فارسی، صدا را زودتر نهایی کنید. اگر دیالوگ مستقیم میسازید، جمله را کوتاه و گوینده را مشخص کنید.
- هر بار یک چیز را تغییر دهید: حرکت، نور یا توضیح سوژه. تغییر همزمان همه تنظیمات، پیداکردن علت بهبود را سخت میکند.
- شاتهای منتخب را تدوین کنید، نوشته فارسی و لوگو را اضافه کنید و هماهنگی صدا، رنگ و خروجی نهایی را بررسی کنید.
پرامپت ساده برای ویدیوی واقعگرایانه
بهجای فهرست طولانی صفتها، سوژه، حرکت، دوربین، نور و صدا را مشخص کنید. نمونه زیر برای یک شات تبلیغاتی آرام است؛ در مدل بدون صدا، بخش صوت را در تدوین انجام دهید.
A realistic studio close-up of a silver laptop on a clean blue desk. The camera slowly moves closer. Soft side lighting, natural reflections, stable product shape. One continuous shot. Quiet room ambience, no speech, no music.پرامپت برای انیمیشن و حفظ ظاهر شخصیت
اول تصویر شخصیت را بسازید و تأیید کنید؛ سپس از همان عکس برای image-to-video استفاده کنید. در پرامپت بیشتر روی حرکت تمرکز کنید. برای انیمیشن دقیق با ریگ، کنترل فریمبهفریم و زمانبندی ثابت، نرمافزار انیمیشن هنوز ابزار اصلی است؛ مدل مولد بیشتر برای شات، ایده و تولید سریع کاربرد دارد.
Use the reference character and preserve its face, outfit and proportions. A stylized 3D character gently waves once, smiles, then holds the pose. Static camera, soft studio lighting, simple background. One continuous shot, subtle motion.آموزش اجرای لوکال با ComfyUI؛ شروع با Wan2.2 5B
ComfyUI محیطی است که مراحل تولید را به شکل بخشهای متصل نشان میدهد. برای شروع، قالب رسمی Wan2.2 را دنبال کنید؛ لازم نیست اولین روز یک روند پیچیده از صفر بسازید.
- ComfyUI و درایور سازگار GPU را نصب و بهروز کنید. قالب Wan2.2 5B را از کتابخانه Templates باز کنید.
- فایل مدل diffusion، کدگذار متن و VAE خواستهشده در همان قالب را دریافت و در پوشههای مشخصشده قرار دهید.
- در بخشهای بارگذاری، همان فایلها را انتخاب کنید. برای تصویر به ویدیو، عکس ورودی را هم در Load Image قرار دهید.
- با طول و ابعاد پیشفرض قالب و یک حرکت ساده شروع کنید. نتیجه را ذخیره کنید و بعد طول یا کیفیت را افزایش دهید.
- در خطای کمبود حافظه، ابتدا ابعاد یا تعداد فریم را کم کنید و تنظیمات offload را بررسی کنید.
- برای آفلاین واقعی، وابستگیها و فایلها را از قبل دریافت کنید و مطمئن شوید هیچ بخش قالب به API آنلاین متصل نیست.

در آموزش رسمی Wan2.2 در ComfyUI فایلها و مراحل همان قالب را بررسی کنید. برای نسخه 5B، مدل ویدیویی، text encoder و VAE لازماند؛ فایل مدل بهتنهایی کافی نیست.
برای LTX هم از قالب رسمی همان نسخه شروع کنید. بخش صوت و فایلهای لازم را مطابق قالب بارگذاری کنید؛ صرفِ تولید فایل MP4 ثابت نمیکند که خروجی ترک صوتی دارد. خروجی را با صدا پخش کنید. نام مدل، نسخه نرمافزار، seed، ابعاد، تعداد فریم و زمان تولید را ذخیره کنید تا شات قابل تکرار باشد.
برای ساخت ویدیوی لوکال چه سختافزاری لازم است؟
اول GPU و VRAM را انتخاب کنید، بعد CPU و RAM را. حافظه گرافیکی فضای کار مدل است؛ RAM بیشتر میتواند به offload کمک کند، ولی جای VRAM سریع را نمیگیرد. تعداد هسته CPU یا عدد TOPS روی NPU هم بهتنهایی نشان نمیدهد مدل ویدیویی شما چقدر سریع اجرا میشود. بسیاری از روندهای رایج برای NVIDIA و CUDA مستند شدهاند؛ روی AMD و Intel باید پشتیبانی همان مدل و نرمافزار را جدا بررسی کنید.
| سطح استفاده | راهنمای انتخاب | انتظار واقعبینانه |
|---|---|---|
| یادگیری و آزمایش سبک | GPU با ۸ تا ۱۲GB، فقط قالبهای سازگار و بهینهشده | کلیپ کوتاه و offload؛ زمان بیشتر قابل انتظار است |
| کار جدی با Wan و Hunyuan | ۲۴GB VRAM نقطه شروع قابل بررسی؛ RAM کافی برای offload | نتیجه به مدل، طول، ابعاد و قالب بستگی دارد |
| روند رسمی LTX | مستندات فعلی: GPU انویدیا با ۳۲GB+، RAM حداقل ۳۲GB و ۱۰۰GB فضای آزاد | حداقل اعلامی، تضمین سرعت پروداکشن نیست |
| استودیو و تولید پیوسته | VRAM بیشتر و کانفیگ متناسب با آزمون واقعی پروژه | ظرفیت و سرعت را با چند شات نماینده اندازه بگیرید |
برای ایستگاه کاری، ۶۴ تا ۱۲۸GB RAM و SSD یک یا دو ترابایتی میتواند نقطه شروع پیشنهادی برای فضای کار راحتتر باشد؛ این توصیه خرید است، نه حداقل رسمی همه مدلها. ظرفیت بیشتر به حجم مدلها، تعداد کارهای همزمان و نگهداری خروجیها بستگی دارد. چند GPU هم خودبهخود حافظه را یکپارچه نمیکند؛ روند اجرا باید از تقسیم مدل یا پردازش توزیعشده پشتیبانی کند.
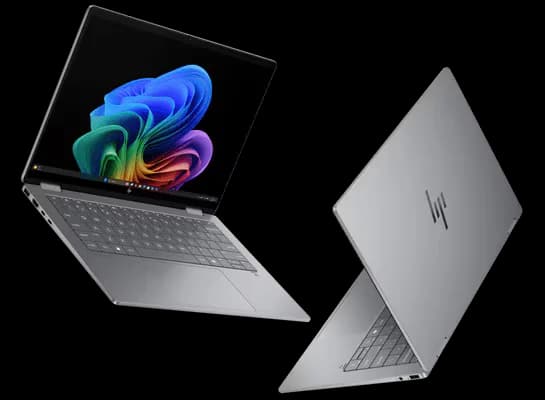
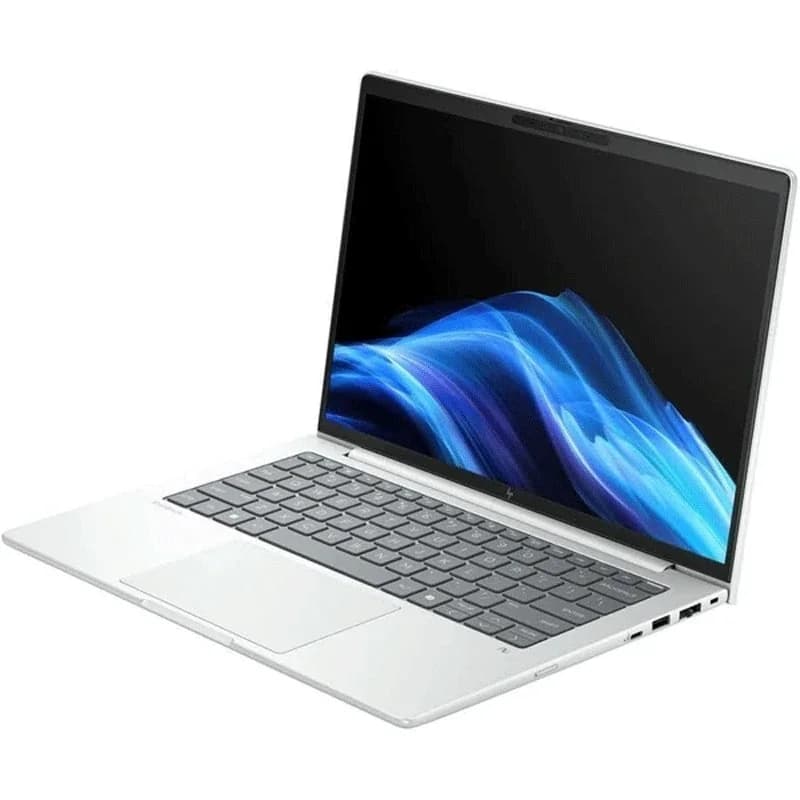
دو لپتاپ و دو سرور برای روند تولید ویدیوی هوش مصنوعی
اگر میخواهید مدل لوکال را برای تولید حرفهای به کار بگیرید، میتوانید سرورهای قابلپیکربندی زیر را با GPU و حافظه مناسب پروژه انتخاب و خریداری کنید. برای هدف «خیلی سریع»، قبل از نهاییکردن کانفیگ، زمان تولید همان مدل و همان کیفیت را اندازه بگیرید؛ نام سرور یا تعداد CPU بهتنهایی تضمین سرعت نیست.
چهار گزینه زیر در یک مجموعه آمدهاند: دو لپتاپ برای مدیریت پروژه، کار با ابزارهای آنلاین و اتصال به سرور، و دو سرور برای پردازش محلی. OmniBook X Flip 14 و EliteBook 8 G1i موجود، گرافیک مجزای NVIDIA ندارند؛ بنابراین آنها را برای اجرای سریع مدلهای سنگین CUDA پیشنهاد نمیکنیم. برای تولید سنگین، نقش پردازش را به سرور بدهید.
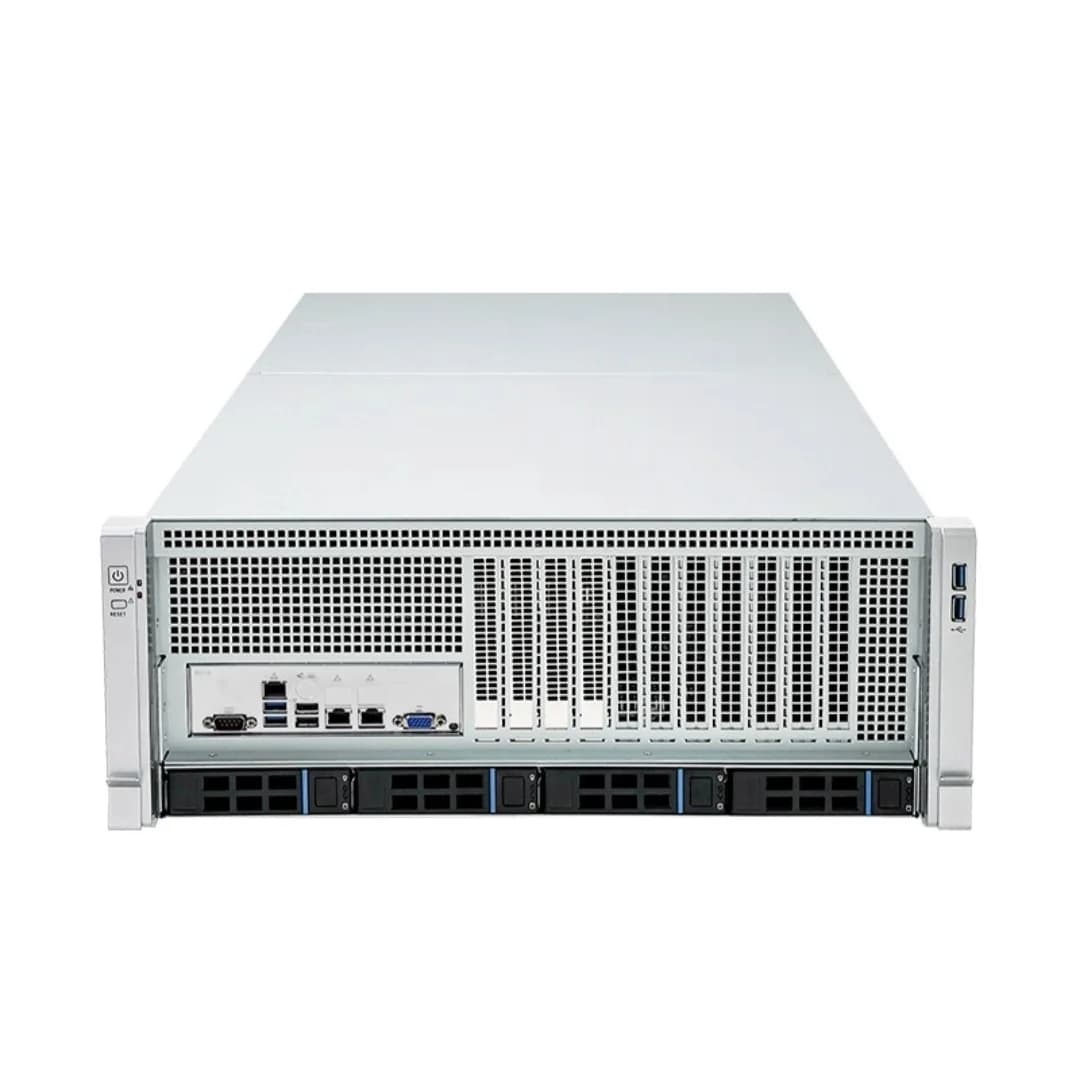
Atlas R1 در کاتالوگ با دو Xeon Platinum 8582C و حافظه DDR5 ECC، و Atlas R4 با دو Xeon Platinum 8383C و DDR4 ECC معرفی شدهاند. هر دو گزینههای انتخاب RAM، ذخیرهسازی و GPU دارند. برای ویدیو، انتخاب GPU با VRAM کافی از تفاوت CPUها مهمتر است. گزینههای ۳۲GB یا بالاتر را متناسب با مدل بررسی کنید؛ برخی انتخابها پیشسفارشاند و کانفیگ پایه را نباید معادل سیستم آماده تولید ویدیو فرض کرد. سازگاری ابعاد کارت، برق، خنککاری و نرمافزار باید هنگام سفارش تأیید شود.
هزینه آنلاین یا خرید سیستم؛ کدام بهصرفهتر است؟
اگر ماهی چند کلیپ میسازید، آنلاین معمولاً شروع کمهزینهتری دارد. اگر هر روز خروجی میگیرید، فایل خصوصی دارید یا به نسخه ثابت و روند سفارشی نیاز دارید، لوکال ارزش محاسبه دارد. قیمت اشتراک بهتنهایی معیار کافی نیست؛ تعداد شاتهای خراب، افزایش کیفیت، لبخوانی و صدا هم هزینه دارند.
هزینه هر خروجی قابل استفاده را اینطور حساب کنید: مجموع هزینه تولید، تکرار، صدا و افزایش کیفیت، تقسیم بر تعداد کلیپهایی که واقعاً تحویل میدهید. برای لوکال هم هزینه خرید و استهلاک، برق، نگهداری و زمان اپراتور را وارد کنید. روی پروژه واقعی یک آزمون کوچک بگیرید، بعد برای خرید سیستم یا اشتراک بلندمدت تصمیم بگیرید. پیش از پرداخت، دسترسی کشور، روش پرداخت، واترمارک و حق استفاده تجاری همان سرویس را بررسی کنید.
چطور خروجی را طبیعیتر و قابل تحویل کنیم؟
- برای محصول، تصویر مرجع دقیق بدهید؛ شکل پورتها، دکمهها و لوگو را در چند فریم کنترل کنید.
- در هر شات یک حرکت اصلی داشته باشید. حرکت پیچیده بدن، دوربین و اشیای زیاد، خطایابی را سخت میکند.
- برای ثبات شخصیت، عکسهای مرجع و توضیح لباس و چهره را در شاتها ثابت نگه دارید.
- نوشته فارسی، زیرنویس، قیمت و لوگوی نهایی را در تدوین اضافه کنید تا غلط املایی و تغییر شکل حروف کنترل شود.
- دستها، دندانها، بازتابها، تغییر ناگهانی چهره و تداوم اشیا را فریمبهفریم بررسی کنید.
- افزایش وضوح، مشکل حرکت یا تلفظ را اصلاح نمیکند؛ اول شات درست را انتخاب کنید، بعد کیفیت نهایی بگیرید.
- برای گفتار، ابتدا صدای تنها را گوش کنید؛ سپس لبخوانی، مکثها و هماهنگی انتهای جمله را بازبینی کنید.
پرسشهای پرتکرار
بهترین مدل ساخت ویدیو با هوش مصنوعی کدام است؟
برای همه پروژهها یک مدل برتر وجود ندارد. برای تصویر واقعگرایانه همراه صدا Veo، Kling و Seedance را مقایسه کنید؛ برای اجرای لوکال LTX و Wan گزینههای مهمیاند. انتخاب نهایی را با نمونه پروژه خودتان انجام دهید.
کدام مدلها همزمان ویدیو و صدا میسازند؟
Veo 3.1، Kling 3.0 در حالت پشتیبانیشده، Seedance 2.5 و 2.0، MiniMax H3، Grok Imagine Video 1.5 و مدلهای صوتیتصویری LTX این قابلیت را دارند. صدای همزمان، تضمین گفتار فارسی روان نیست.
آیا میتوان بدون اینترنت ویدیو تولید کرد؟
بله، اگر وزن مدل، نرمافزار و همه اجزای لازم از قبل دانلود شده باشند و روند تولید به API یا بخش ابری وابسته نباشد. دموهای آنلاین Hugging Face بهخودیخود آفلاین نیستند.
برای ویدیوی فارسی، صدای مستقیم بهتر است یا دوبله؟
برای کنترل تلفظ و لهجه، ابتدا صدای فارسی را ضبط یا با TTS پشتیبان فارسی تولید و تأیید کنید؛ سپس تصویر و لبخوانی را با آن هماهنگ کنید. برتری طبیعیبودن به آزمون صوتی همان متن نیاز دارد.
آیا لپتاپ AI برای تولید سریع ویدیو کافی است؟
عنوان AI و داشتن NPU کافی نیست. GPU، VRAM، سازگاری نرمافزار و توان پایدار دستگاه مهماند. دو لپتاپ معرفیشده این مقاله برای مدیریت کار و اتصال به سرور مناسباند؛ اجرای سنگین CUDA به سختافزار دیگری نیاز دارد.
آیا مدلهای هاجینگ فیس برای کار تجاری آزادند؟
باید مجوز همان مخزن و نسخه را بخوانید. مجوز Wan، LTX، Hunyuan و MiniMax یکسان نیست و قابل دانلود بودن وزن، به معنی استفاده تجاری بدون شرط نیست.
منابع و راههای بررسی نسخهها
برای جزئیات بیشتر، راهنمای Gen-4.5، پرسشهای Ray3.14، مستندات Grok Video، زبانهای ElevenLabs و نیازمندیهای LTX را ببینید. لینک دریافت مدلها در بخش مربوط به هر مدل قرار دارد. امکانات، هزینه و دسترسی ممکن است پس از آپدیت مهر ۱۴۰۵ تغییر کنند.
همچنین توضیح Adobe درباره افکت صوتی، معرفی Pika و مجوز فعلی H3 مبنای تفکیک قابلیتها و شرایط استفادهاند.
اولین دیدگاه مفید درباره این مطلب را شما بنویسید.