برای اجرای مدل زبانی روی کامپیوتر، اولین قدم انتخاب یک مدل متناسب با سیستم و نیاز شماست؛ نه لزوما خرید سختافزار گرانقیمت. بعضی مدلهای کوچک روی کامپیوترهای معمولی هم اجرا میشوند، اما مدلهای بزرگتر به حافظه بیشتر و توان پردازشی بالاتری نیاز دارند. انتخاب درست کمک میکند پیش از صرف هزینه برای ارتقای سیستم، بدانید از سختافزار فعلی خود چه استفادهای میتوانید بکنید.
سرعت پاسخگویی و کیفیت خروجی فقط به قدرت کامپیوتر بستگی ندارد. اندازه مدل، مقدار RAM و حافظه گرافیکی (VRAM)، توان پردازنده و نسخهای که از مدل زبانی دریافت میکنید، همگی در نتیجه نهایی مؤثرند.
در راهنمای استوکلند، از انتخاب مدل زبانی تا اجرای عملی آن با ابزارهایی مثل Ollama را بررسی میکنیم. حداقل RAM برای اجرای مدل زبانی چقدر است؟ آیا بدون کارت گرافیک هم میتوان مدل را اجرا کرد؟ کدام مدل برای زبان فارسی، برنامهنویسی یا تحلیل اسناد مناسبتر است؟ در ادامه، به این پرسشها پاسخ میدهیم تا بتوانید با شناخت محدودیتهای سیستم خود، مدل مناسبی انتخاب کنید و آن را راهاندازی کنید.
مدل زبانی محلی (Local LLM) چیست؟
مدل زبانی محلی (Local LLM) نوعی مدل زبانی بزرگ (LLM) است که بهجای اجرا روی سرورهای ابری، روی کامپیوتر شخصی یا دستگاه محلی کاربر اجرا میشود. این مدلها میتوانند برای تولید متن، پاسخگویی به پرسشها، کمک به برنامهنویسی و خلاصهسازی اسناد به کار بروند. البته نوع کاربرد و کیفیت پاسخها به مدل انتخابی بستگی دارد.
اجرای محلی این امکان را میدهد که پس از دانلود مدل و فراهمکردن ابزارهای لازم، از مدلهای سازگار بدون اتصال دائمی به اینترنت استفاده کنید. همچنین، در اجرای کاملا محلی، درخواستها روی دستگاه خودتان پردازش میشوند. مزیتی که میتواند برای حفظ حریم خصوصی مفید باشد. البته سرعت اجرا، کیفیت پاسخها و میزان مصرف حافظه به مدل و سختافزار سیستم بستگی دارد.
برای اجرای این مدلها میتوانید از ابزارهایی مانند Ollama استفاده کنید که دریافت و راهاندازی مدلهای زبانی را ساده میکند. توجه داشته باشید که Ollama خودِ مدل زبانی نیست؛ بلکه ابزاری برای اجرای آنهاست. همچنین، اجرای محلی با استفاده از ChatGPT در مرورگر یکسان نیست؛ ChatGPT یک محصول هوش مصنوعی است و اجرای محلی به شما امکان میدهد مدل سازگار را روی دستگاه خودتان اجرا کنید.
اجرای مدل زبانی روی کامپیوتر چه مزایایی دارد؟
اجرای مدل زبانی روی کامپیوتر شخصی، راهی برای استفاده از هوش مصنوعی با وابستگی کمتر به سرویسهای آنلاین است. میتوانید مدل موردنظرتان را انتخاب کنید، آن را روی سیستم خود اجرا کنید و برای کارهایی مثل نوشتن متن، پاسخگویی به سؤالها یا کمک به برنامهنویسی از آن کمک بگیرید. حفظ حریم خصوصی، امکان استفاده آفلاین و آزادی بیشتر در انتخاب مدل از دلایلی هستند که اجرای مدلهای زبانی محلی (Local LLM) را جذاب میکنند. البته تجربه شما به مدل و سختافزاری که در اختیار دارید هم بستگی دارد.
حفظ حریم خصوصی هنگام استفاده از مدلهای زبانی
وقتی مدل را روی کامپیوتر خودتان اجرا میکنید، درخواستها میتوانند همانجا پردازش شوند و برای دریافت پاسخ به سرورهای ابری فرستاده نشوند. این موضوع هنگام کار با اسناد شخصی، فایلهای کاری یا کدهای اختصاصی اهمیت دارد. البته یک نکته را فراموش نکنید: محلیبودن مدل بهتنهایی امنیت کامل را تضمین نمیکند؛ ابزار اجرا و برنامههای جانبی هم نباید اطلاعات را بدون اطلاع شما به سرویس دیگری بفرستند.
اجرای مدل زبانی بدون اینترنت
اگر مدل و ابزارهای لازم را از قبل دانلود کرده باشید، معمولا میتوانید مدل زبانی محلی را بدون اتصال دائمی به اینترنت اجرا کنید. این ویژگی زمانی به کارتان میآید که اینترنت در دسترس نیست یا نمیخواهید برای هر درخواست به یک سرویس آنلاین متکی باشید. البته برای دانلود مدلهای تازه، دریافت بهروزرسانیها و استفاده از بعضی قابلیتهای آنلاین، همچنان به اینترنت نیاز دارید.
انتخاب مدل هوش مصنوعی متناسب با نیاز کاربر
قرار نیست همه مدلهای زبانی برای همه کارها مناسب باشند. ممکن است یک مدل برای گفتوگوی روزمره کافی باشد، اما برای برنامهنویسی یا تحلیل متن به گزینه دیگری نیاز داشته باشید. هنگام انتخاب مدل، علاوه بر کاربرد آن، باید به اندازه مدل، نسخه کوانتیزهشده و سازگاریاش با RAM و حافظه گرافیکی (VRAM) سیستم هم توجه کنید. چون این عوامل روی امکان اجرا و سرعت پاسخگویی تأثیر میگذارند.
وابستگی کمتر به سرویسهای ابری و اشتراکها
اگر یک مدل محلی نیازهای روزمرهتان را برطرف کند، ممکن است کمتر به خرید اشتراک سرویسهای آنلاین نیاز داشته باشید. بااینحال، اجرای محلی هم هزینههای خودش را دارد؛ از مصرف برق گرفته تا فضای ذخیرهسازی و سختافزار مناسب. از طرف دیگر، نباید انتظار داشت هر مدل محلی از نظر کیفیت پاسخ، سرعت یا امکانات با سرویسهای آنلاین رقابت کند. انتخاب خوب، مدلی است که با نیاز واقعی شما و توان سیستمتان جور دربیاید.
برای اجرای مدل زبانی روی کامپیوتر به چه سختافزاری نیاز داریم؟
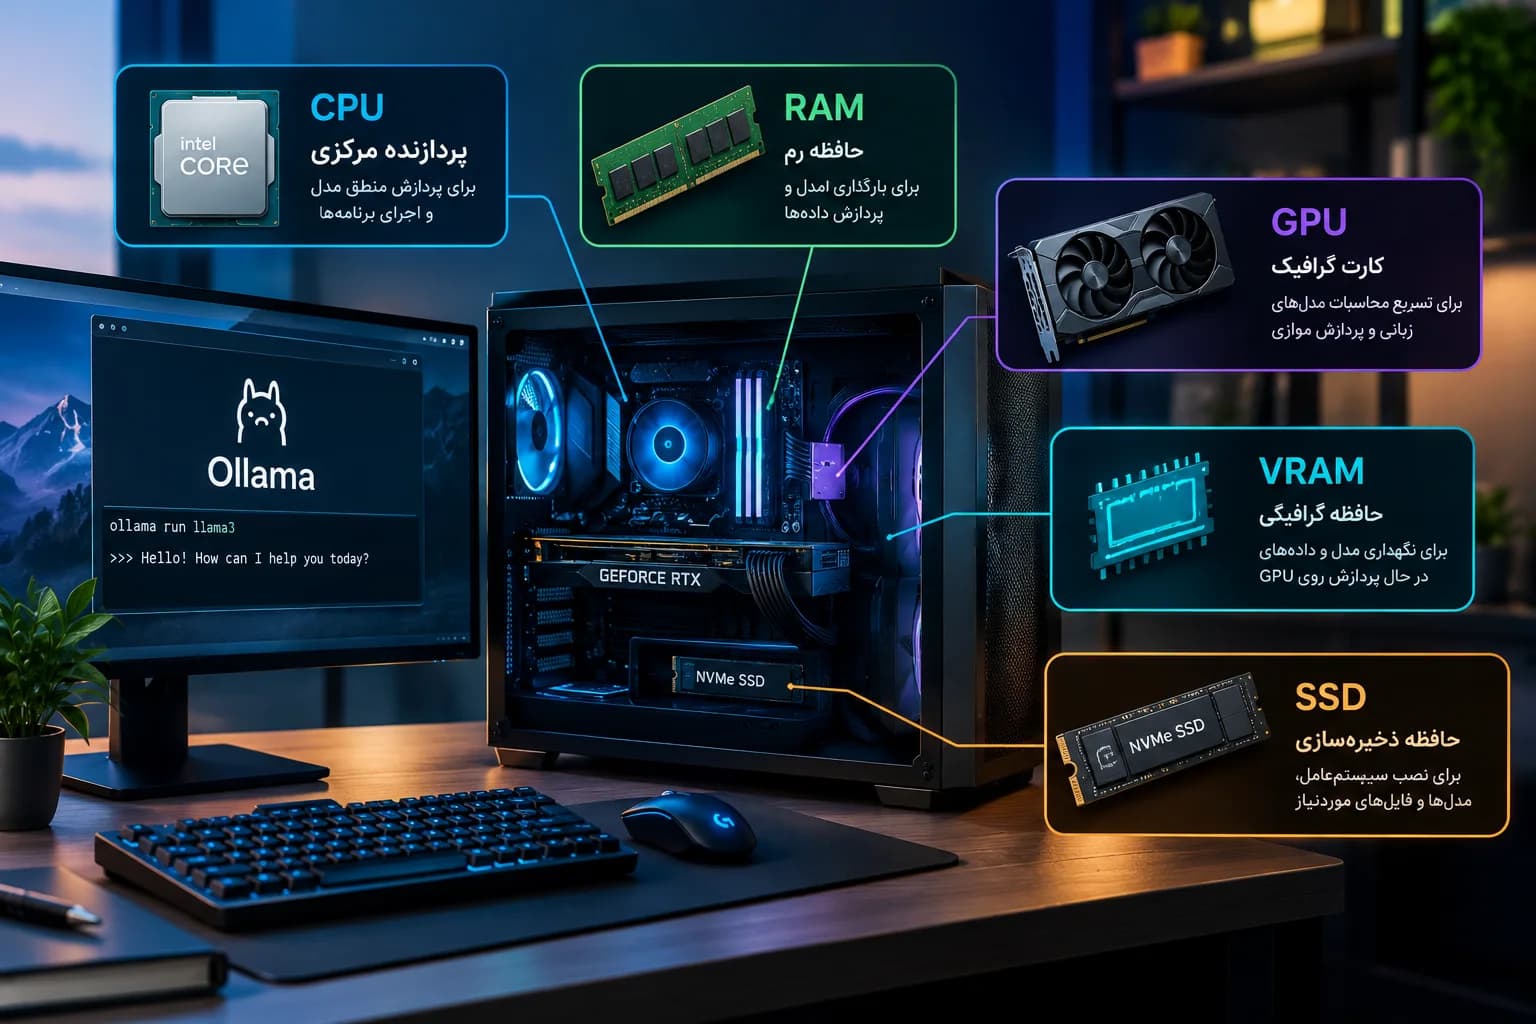
برای انتخاب سختافزار مناسب اجرای مدل زبانی روی کامپیوتر، بهتر است از نیازتان شروع کنید، نه از قیمت قطعات. اگر هدف شما اجرای یک مدل کوچک برای گفتوگو و کارهای روزمره است، ممکن است همین کیس یا لپتاپ فعلیتان کافی باشد. اما برای کار با مدلهای بزرگتر، تحلیل متنهای طولانی یا دریافت پاسخهای سریعتر، باید ظرفیت RAM، حافظه گرافیکی (VRAM) و توان پردازنده (CPU) را دقیقتر بررسی کنید. پیش از ارتقای سیستم، ابتدا مدل موردنظرتان و منابع موردنیاز آن را مشخص کنید. گاهی انتخاب یک مدل سبکتر یا نسخه کوانتیزهشده، از خرید سختافزار گرانقیمت منطقیتر است.
RAM موردنیاز برای اجرای مدل زبانی
RAM یکی از مهمترین مشخصات برای اجرای مدل زبانی روی کامپیوتر است. این حافظه فضای لازم برای بارگذاری مدل و انجام پردازشهای حین اجرا را فراهم میکند. برای شروع، ۱۶ گیگابایت RAM میتواند نقطه شروع مناسبی برای اجرای بسیاری از مدلهای کوچک و برخی مدلهای میانرده باشد؛ اما اگر سراغ مدلهای بزرگتر بروید یا بخواهید متنهای طولانیتری را تحلیل کنید، ممکن است به حافظه بیشتری نیاز داشته باشید.
برای انتخاب مقدار مناسب RAM، فقط به حجم فایل مدل توجه نکنید. بخشی از حافظه هنگام اجرای مدل صرف وزنهای آن میشود و بخش دیگری برای اطلاعات پردازشی، پنجره زمینه (Context Window) و خود سیستمعامل لازم است. به همین دلیل، مدلی که فایل آن چند گیگابایت حجم دارد، ممکن است هنگام اجرا به حافظه بیشتری نیاز داشته باشد.
اگر کامپیوتر شما ۸ گیگابایت RAM دارد، بهتر است ابتدا مدلهای کوچکتر و نسخههای کوانتیزهشده را بررسی کنید. با ۱۶ گیگابایت، گزینههای بیشتری برای شروع خواهید داشت و ۳۲ گیگابایت RAM میتواند برای مدلهای بزرگتر، متنهای طولانیتر یا اجرای همزمان چند برنامه فضای بیشتری فراهم کند. البته این اعداد تضمین نمیکنند که هر مدلی با این مقدار حافظه بهخوبی اجرا شود؛ اندازه و نسخه مدل نیز تعیینکنندهاند.
| RAM سیستم | مدلهای مناسب برای شروع | پیشنهاد کاربردی |
|---|---|---|
| ۸ گیگابایت | مدلهای کوچک، معمولا ۱B تا ۳B؛ برخی مدلهای فشردهتر | برای آزمایش و گفتوگوی ساده مناسبتر است؛ برنامههای اضافی را ببندید. |
| ۱۶ گیگابایت | مدلهای کوچک و بسیاری از مدلهای ۷B تا ۸B کوانتیزهشده | نقطه شروع مناسبی برای استفاده روزمره و بررسی مدلهای محلی است. |
| ۳۲ گیگابایت | مدلهای ۷B تا ۱۴B و برخی مدلهای بزرگتر، بسته به نسخه | برای انتخابهای بیشتر و کار با متنهای طولانیتر فضای مناسبتری دارید. |
| ۶۴ گیگابایت یا بیشتر | برخی مدلهای ۳۰B تا ۷۰B، طبق کوانتیزهسازی و تنظیمات | برای مدلهای بزرگتر مناسبتر است؛ اما پیش از دانلود باید نیاز واقعی مدل را بررسی کنید. |
نقش کارت گرافیک (GPU) در اجرای LLM
کارت گرافیک (GPU) میتواند اجرای مدل زبانی بزرگ (LLM) را سریعتر کند. زیرا بخشی از محاسبات مدل بهجای پردازنده مرکزی (CPU)، روی GPU انجام میشود. برای اجرای روان مدلهای زبانی روی کامپیوتر، فقط اسم و رده کارت گرافیک تعیینکننده نیست؛ معماری GPU و قابلیتهای پردازش هوش مصنوعی آن هم اهمیت دارند. هنگام مقایسه کارتها، به هستههای اختصاصی هوش مصنوعی (مثل Tensor Cores در کارتهای NVIDIA)، پهنای باند حافظه و پشتیبانی از دقتهای محاسباتی مانند FP16 و BF16 توجه کنید. این قابلیتها میتوانند روی سرعت اجرای مدل اثر بگذارند. البته نتیجه نهایی به مدل و نرمافزار مورد استفاده هم بستگی دارد. برای مثال، کارتهای GeForce RTX 50 از معماری Blackwell و نسل پنجم Tensor Cores استفاده میکنند. در کنار این مشخصات، مصرف برق کارت و توان پاور سیستم را هم بررسی کنید تا انتخابتان فقط روی کاغذ مناسب نباشد و با کیس فعلیتان هم جور دربیاید.
هنگام خرید کارت گرافیک برای اجرای مدل زبانی روی کامپیوتر، این مشخصات را بررسی کنید:
- - ظرفیت حافظه گرافیکی (VRAM): برای شروع، کارتهای ۸ گیگابایتی گزینه مناسبی برای اجرای برخی مدلهای کوچک هستند. ظرفیت ۱۲ یا ۱۶ گیگابایت نیز دست شما را برای انتخاب مدلهای بیشتری باز میگذارد. برای مثال، RTX 3060 با ۱۲ گیگابایت و RTX 5060 Ti با ۱۶ گیگابایت.
- - پهنای باند حافظه (Memory Bandwidth): پهنای باند با واحد GB/s اندازهگیری میشود و بر سرعت انتقال دادهها اثر میگذارد. برای نمونه، پهنای باند RTX 5060 Ti برابر ۴۴۸ و RTX 5070 Ti برابر ۸۹۶ گیگابایتبرثانیه است. البته این عدد بهتنهایی سرعت اجرای مدل زبانی را مشخص نمیکند.
- - معماری و قابلیتهای پردازش هوش مصنوعی: فقط تعداد هستهها یا فرکانس GPU را مقایسه نکنید. معماری کارت و قابلیتهای پردازش هوش مصنوعی نیز اهمیت دارند. برای مثال، کارتهای سری RTX 50 از معماری Blackwell و نسل پنجم Tensor Core استفاده میکنند. سازگاری این قابلیتها با مدل و نرمافزار موردنظر را هم بررسی کنید.
- - سازگاری با ابزار اجرای مدل: پیش از انتخاب کارت، پشتیبانی نرمافزاری آن را بررسی کنید. اگر میخواهید از Ollama استفاده کنید، پشتیبانی نرمافزاری کارت دقیق خود را بررسی کنید. : برای مثال، مستندات رسمی Ollama فهرست سختافزارهای گرافیکی پشتیبانیشده را ارائه میدهد که به مدل کارت، درایور و سیستمعامل بستگی داشته باشد.
- - مصرف برق و سازگاری با کیس: توان مصرفی کارت، پاور موردنیاز، کانکتور برق و ابعاد آن را پیش از خرید بررسی کنید. ممکن است کارت گرافیک از نظر VRAM مناسب باشد، اما با پاور یا فضای کیس فعلی شما سازگار نباشد.
- - عملکرد واقعی در اجرای مدل زبانی: در مقایسه دو کارت، بنچمارک یک مدل یکسان را با تنظیمات و طول زمینه مشابه بررسی کنید. سرعت تولید پاسخ معمولا با واحد توکنبرثانیه (tokens/s) گزارش میشود. همچنین بررسی کنید مدل بهطور کامل در حافظه گرافیکی (VRAM) جا میگیرد یا بخشی از پردازش به RAM و CPU منتقل میشود.
حافظه گرافیکی (VRAM) موردنیاز برای اجرای LLM
کارت گرافیک (GPU) در اجرای محلی مدلهای زبانی بزرگ (LLM) هم وظیفه پردازش محاسبات مدل را بر عهده دارد و هم از حافظه گرافیکی (VRAM) برای نگهداری وزنهای مدل و دادههای موردنیاز هنگام تولید پاسخ استفاده میکند. ظرفیت VRAM مشخص میکند چه مدلهایی را میتوانید با چه تنظیماتی اجرا کنید؛ توان پردازشی GPU و پهنای باند حافظه نیز بر سرعت اجرای مدل اثر میگذارند. برای مثال، کارت گرافیک با ۸ گیگابایت VRAM میتواند نقطه شروع مناسبی برای مدلهای کوچک و برخی نسخههای فشردهشده باشد؛ اما برای اجرای مدلهای بزرگتر یا استفاده از زمینه متنی طولانی، حافظه بیشتری نیاز دارید. البته مقدار دقیق حافظه به اندازه مدل، میزان فشردهسازی وزنها و طول متن ورودی و گفتوگو بستگی دارد.
برای انتخاب کارت گرافیک، بهتر است مقدار VRAM را متناسب با مدل موردنظر بررسی کنید. جدول زیر یک راهنمای تقریبی برای شروع است؛ زیرا نیاز واقعی هر مدل به اندازه آن، نسخه کوانتیزهشده و طول پنجره زمینه (Context Window) بستگی دارد.
| حافظه گرافیکی (VRAM) | مدلهای مناسب برای بررسی | پیشنهاد کاربردی |
|---|---|---|
| ۴ گیگابایت | مدلهای کوچک و نسخههای فشرده | برای آزمایش مدلهای سبک مناسبتر است؛ ممکن است محدودیت حافظه داشته باشید. |
| ۸ گیگابایت | مدلهای کوچک و برخی مدلهای ۷B تا ۸B کوانتیزهشده | نقطه شروع مناسبی برای بررسی مدلهای محلی سبک است. |
| ۱۲ گیگابایت | بسیاری از مدلهای ۷B تا ۸B کوانتیزهشده و برخی مدلهای بزرگتر | گزینههای بیشتری برای انتخاب مدل خواهید داشت. |
| ۱۶ گیگابایت | مدلهای میانرده و برخی مدلهای بزرگتر، بسته به نسخه | برای آزمایش مدلهای متنوعتر و کار با متنهای طولانیتر فضای بیشتری فراهم میکند. |
| ۲۴ گیگابایت یا بیشتر | مدلهای بزرگتر یا نسخههایی با فشردهسازی کمتر | برای اجرای مدلهای حافظهبر مناسبتر است؛ نیاز دقیق مدل را بررسی کنید. |
پردازنده (CPU) و سرعت اجرای مدل زبانی
برای انتخاب پردازنده (CPU) مناسب اجرای مدلهای زبانی بزرگ (LLM)، فقط سراغ بیشترین تعداد هسته یا بالاترین فرکانس نروید! مهم این است که پردازنده با شیوه اجرای مدل شما تناسب داشته باشد. اگر میخواهید مدل را مستقیما روی CPU اجرا کنید، قدرت پردازش هر هسته، تعداد هستهها، پشتیبانی از دستورالعملهایی مانند AVX2 و AVX-512 و پهنای باند حافظه را با دقت بیشتری بررسی کنید. اما اگر کارت گرافیک هم دارید، یک CPU جدید و متعادل معمولا نقطه شروع منطقیتری از هزینهکردن برای پردازندهای بسیار گرانقیمت است. بهویژه زمانی که بیشتر محاسبات روی GPU انجام میشوند. بااینحال، وقتی بخشی از مدل بهدلیل محدودیت حافظه گرافیکی روی CPU اجرا میشود، توان پردازنده و سرعت RAM اهمیت بیشتری پیدا میکنند. برای تصمیم دقیقتر، بنچمارک CPU را با همان مدل و نرمافزاری بررسی کنید که قصد استفاده از آن را دارید؛ زیرا تعداد هستهها بهتنهایی سرعت تولید پاسخ را مشخص نمیکند.
فضای ذخیرهسازی SSD و حجم فایل مدلها
مدلهای زبانی محلی ممکن است از چند گیگابایت تا صدها گیگابایت فضای ذخیرهسازی نیاز داشته باشند. حجم فایل به تعداد پارامترها، دقت وزنها و روش کوانتیزهسازی (Quantization) بستگی دارد. برای مثال، نسخه کوانتیزهشده Q4_K_M از مدل Llama 3.1 8B حدود ۴٫۹ گیگابایت حجم دارد؛ درحالیکه نسخه 70B همین خانواده در همین قالب حدود ۴۳٫۱ گیگابایت فضا اشغال میکند. مستندات رسمی llama.cpp این اختلاف نشان میدهد که پیش از انتخاب SSD باید حجم فایل دقیق مدل موردنظر را بررسی کنید.
سرعت SSD بیشتر از همه هنگام دانلود، جابهجایی و بارگذاری مدل اهمیت دارد. استفاده از SSD بهجای HDD میتواند بارگذاری فایلهای حجیم را سریعتر کند، اما بهتنهایی تضمین نمیکند که مدل هنگام تولید پاسخ سریعتر عمل کند؛ سرعت تولید متن به توان پردازشی و نحوه اجرای مدل نیز وابسته است. هنگام انتخاب SSD، فقط حجم یک مدل را در نظر نگیرید. اگر چند مدل را برای مقایسه یا کارهای مختلف نگه میدارید، فضای موردنیاز آنها با هم جمع میشود. همچنین بهتر است بخشی از ظرفیت درایو برای سیستمعامل، نرمافزارها، فایلهای موقت و بهروزرسانیها خالی بماند.
تأثیر اندازه مدل، کوانتیزهسازی و پنجره زمینه بر سختافزار موردنیاز
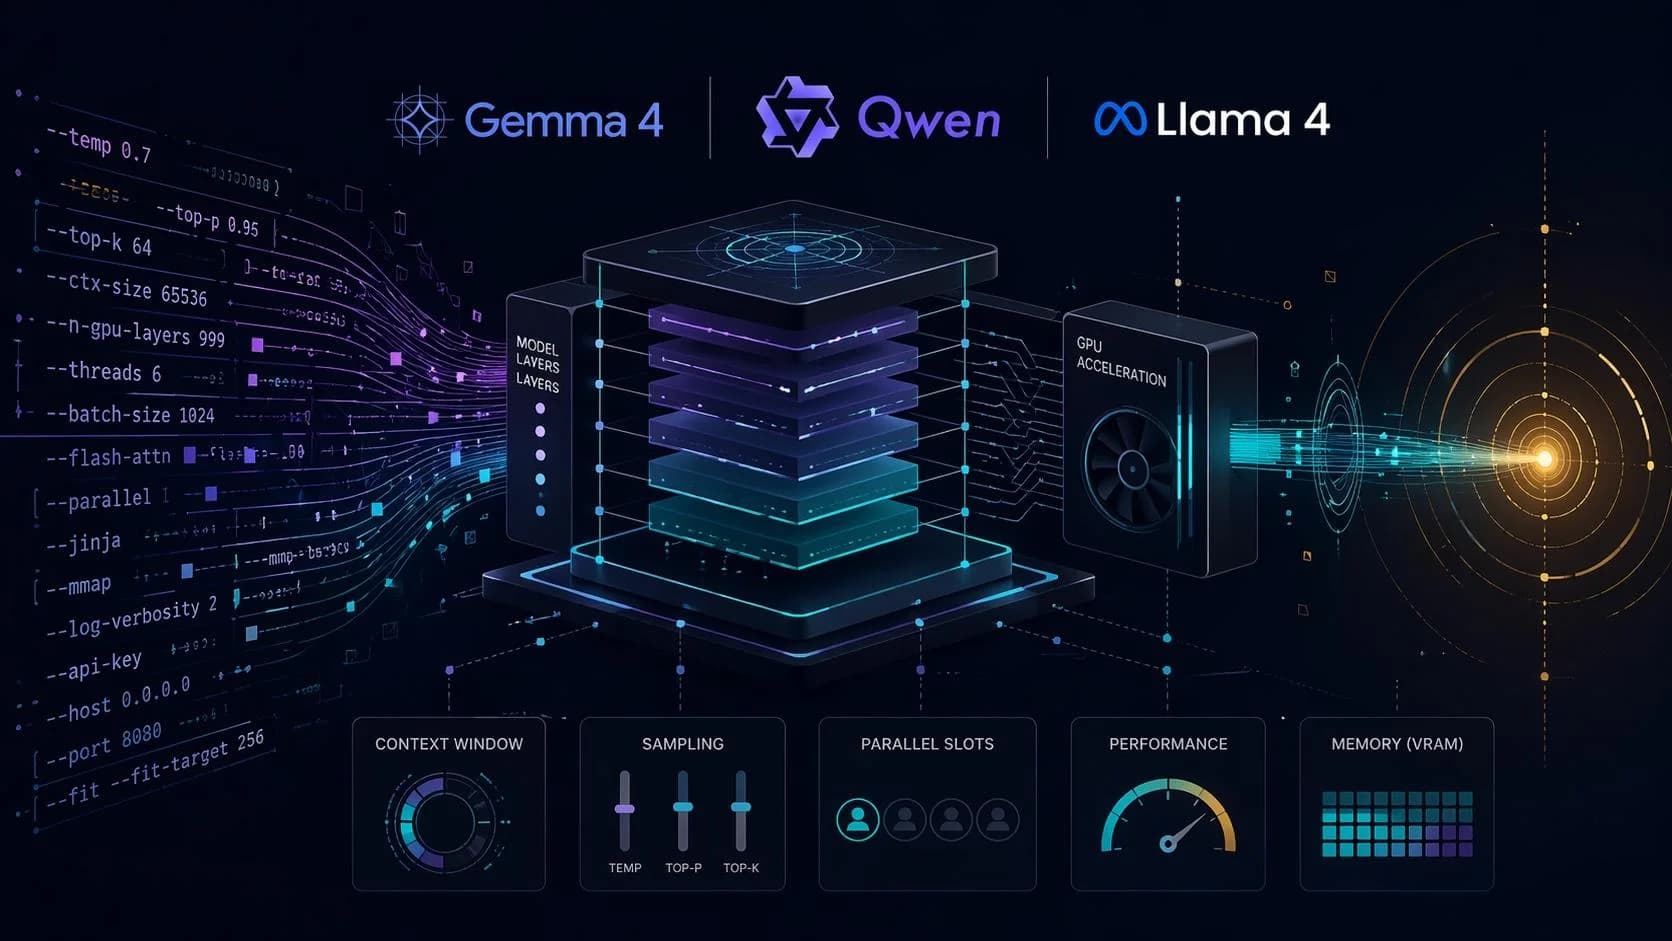
برای انتخاب کامپیوتر مناسب اجرای مدل زبانی بزرگ (LLM) بهصورت محلی، فقط تعداد پارامترهای مدل را در نظر نگیرید. اندازه مدل زبانی، دقت وزنها، روش کوانتیزهسازی (Quantization) و طول پنجره زمینه (Context Window) مشخص میکنند که اجرای مدل به چه مقدار حافظه نیاز دارد و چه محدودیتهایی ممکن است ایجاد شود.
مدلهای زبانی بزرگتر معمولا وزنهای بیشتری دارند و برای بارگذاری به حافظه بیشتری نیاز پیدا میکنند. برای مثال، نسخههای رایج مدل Llama 3.1 در کتابخانه Ollama شامل نسخه ۸ میلیاردپارامتری با کوانتیزهسازی Q4_K_M و حجم حدود ۴٫۹ گیگابایت و نسخه ۷۰ میلیاردپارامتری با حجم حدود ۴۲ گیگابایت هستند. این اختلاف نشان میدهد که افزایش اندازه مدل میتواند نیاز به فضای ذخیرهسازی و حافظه هنگام اجرای LLM را بهشدت افزایش دهد. بااینحال، حجم فایل مدل بهتنهایی معادل کل حافظه موردنیاز برای اجرای آن نیست.
هنگام انتخاب سیستم برای اجرای مدلهای هوش مصنوعی بهصورت محلی، حجم نسخه موردنظر مدل را در کنار حافظه لازم برای اجرا و طول پنجره زمینه بررسی کنید. مدلی که با تنظیمات پیشفرض بهراحتی اجرا میشود، ممکن است با پنجره زمینه طولانی یا چند درخواست همزمان به حافظه بیشتری نیاز پیدا کند.
کوانتیزهسازی (Quantization)
کوانتیزهسازی مدل زبانی با کاهش دقت عددی وزنها، حجم آنها و معمولا نیاز حافظه را کاهش میدهد. برای نمونه، نسخههای Q4 معمولا فضای کمتری از نسخههای با دقت بالاتر اشغال میکنند و برای اجرای محلی LLM روی سختافزار محدود مناسبترند. در مقابل، کاهش دقت میتواند بر کیفیت پاسخ مدل اثر بگذارد؛ میزان این اثر به معماری مدل، روش کوانتیزهسازی و نوع وظیفه بستگی دارد.
پنجره زمینه (Context Window)
پنجره زمینه تعداد توکنهایی را مشخص میکند که مدل میتواند در یک نوبت از متن ورودی، تاریخچه گفتوگو و محتوای مرتبط در نظر بگیرد. هرچه پنجره زمینه بزرگتر باشد، ممکن است حافظه بیشتری برای ذخیرهسازی کلیدها و مقادیر توجه (KV Cache) لازم شود. بنابراین، اجرای یک مدل با پنجره زمینه ۳۲ هزار توکنی میتواند نسبت به همان مدل با پنجره ۴ هزار توکنی حافظه بیشتری مصرف کند. میزان دقیق افزایش به معماری مدل، نوع KV Cache و تنظیمات اجرا بستگی دارد.
البته مدلهای جدیدتر با معماریهای بهینهتر میتوانند هزینه حافظه را در زمینههای طولانی کاهش دهند. برای نمونه، Qwen3 32B در پنجره زمینه ۳۲ هزار توکنی حدود ۸٫۶ گیگابایت حافظه برای KV Cache مصرف میکند. درحالیکه Qwen3.8 27B تنها حدود ۲٫۳ گیگابایت نیاز دارد. این مقایسه نشان میدهد که برای برآورد حافظه موردنیاز اجرای مدل زبانی، فقط تعداد پارامترها کافی نیست و معماری مدل و نحوه مدیریت حافظه نیز اهمیت دارند.
چگونه مدل زبانی مناسب کامپیوتر خود را انتخاب کنیم؟
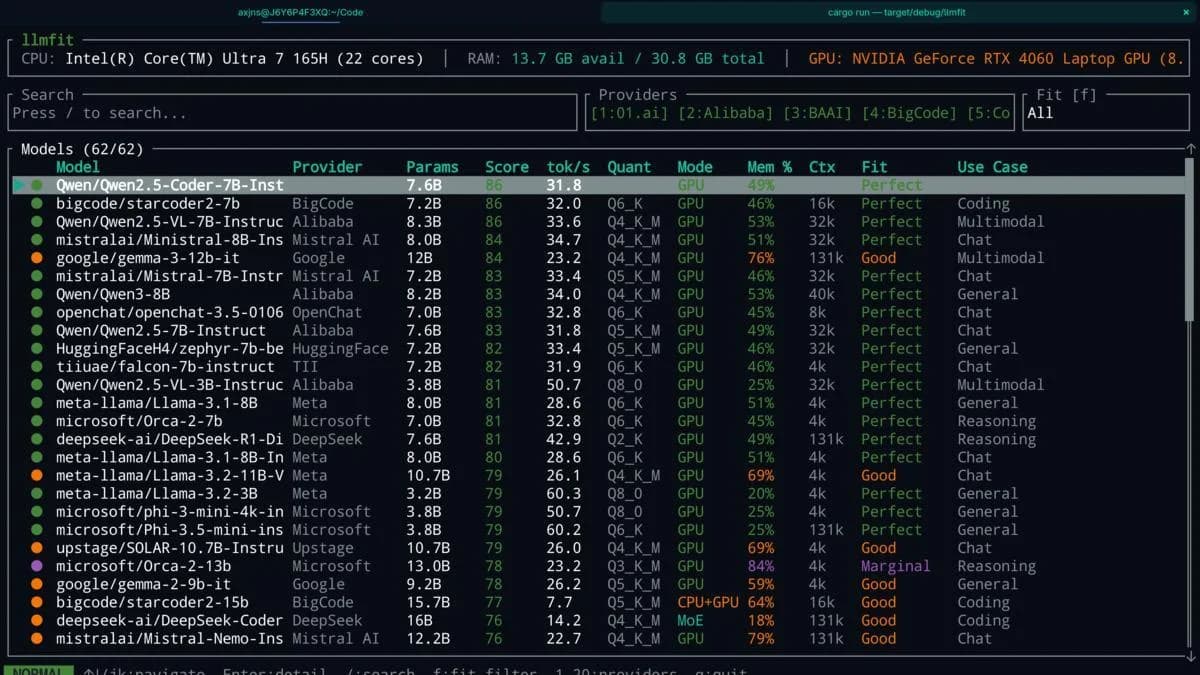
برای انتخاب مدل زبانی مناسب اجرای محلی، باید سه عامل را همزمان در نظر بگیرید: توانایی مدل در انجام وظیفه موردنظر، منابع سختافزاری لازم و سرعت پاسخگویی روی سیستم خودتان. تعداد پارامترها و حجم فایل مدل به تخمین نیاز حافظه کمک میکنند، اما بهتنهایی کیفیت پاسخ یا سرعت اجرا را مشخص نمیکنند. برای شروع، بهتر است مدلهای مختلف را با وظایف یکسان و تنظیمات مشابه آزمایش کنید.
تفاوت مدلهای زبانی 3B، 7B، 8B، 14B و 32B
اعداد 3B، 7B، 8B، 14B و 32B در مدلهای زبانی بزرگ (LLM) به تعداد تقریبی پارامترهای مدل اشاره دارند. برای مثال، مدل زبانی 8B حدود ۸ میلیارد پارامتر دارد. در یک خانواده مدل و با دقت عددی یکسان، افزایش تعداد پارامترها معمولا حجم وزنهای مدل و حافظه موردنیاز برای اجرای محلی هوش مصنوعی را افزایش میدهد. اما مدل زبانی بزرگتر لزوما در همه وظایف عملکرد بهتر یا سرعت پاسخگویی بیشتری ندارد. معماری مدل، دادههای آموزشی، روش تنظیم مدل و نوع کاربرد نیز بر کیفیت خروجی و عملکرد آن تأثیر میگذارند.
بهطور کلی، مدلهای زبانی 3B برای شروع اجرای محلی LLM و انجام وظایف سادهتر، گزینههای کمحجمتری هستند. مدلهای 7B و 8B میتوانند برای چت محلی، گفتوگوی روزمره و کارهای عمومی تعادل مناسبی بین اندازه مدل و توانایی آن ایجاد کنند. مدلهای 14B و 32B نیز برای برخی وظایف پیچیدهتر ارزش بررسی دارند، اما معمولا به منابع سختافزاری بیشتری نیاز دارند. این دستهبندی راهنمای اولیه انتخاب مدل زبانی بر اساس تعداد پارامترهاست، نه تضمین عملکرد؛ انتخاب نهایی باید بر اساس کیفیت مدل در وظیفه موردنظر، سرعت تولید پاسخ و محدودیتهای سختافزار کامپیوتر انجام شود.
چه زمانی باید مدل کوانتیزهشده (Quantized) را انتخاب کنیم؟
کوانتیزهسازی (Quantization) در مدلهای زبانی بزرگ (LLM)، روشی برای نمایش وزنهای مدل با دقت عددی پایینتر است که معمولا حجم فایل مدل و حافظه موردنیاز برای اجرای محلی هوش مصنوعی را کاهش میدهد. برای مثال، نسخه Q4_K_M از یک مدل معمولا کمحجمتر از نسخههای ۸ بیتی یا FP16 همان مدل است. این کاهش حجم میتواند اجرای مدلهای زبانی بزرگتر را روی کامپیوترهایی با RAM یا VRAM محدود امکانپذیر کند. بااینحال، میزان کاهش حجم و تأثیر کوانتیزهسازی بر کیفیت پاسخ به مدل و روش کوانتیزهسازی بستگی دارد.
اگر میخواهید مدل زبانی را بهصورت محلی روی کامپیوتر شخصی اجرا کنید، نسخههای ۴ بیتی معمولا نقطه شروع مناسبی برای آزمایش هستند. بهویژه زمانی که ظرفیت حافظه محدود است. بااینحال، اگر دقت پاسخ در کارهای حساستر، تولید کد یا تحلیل متون تخصصی اهمیت بیشتری دارد، نسخههای با دقت بالاتر را نیز مقایسه کنید. کوانتیزهسازی شدیدتر همیشه انتخاب بهتری نیست. بنابراین، بهتر است کیفیت پاسخ، سرعت تولید متن و مصرف حافظه را با توجه به وظایف واقعی خود بسنجید.
برای شروع اجرای محلی، کدام مدل زبانی مناسبتر است؟
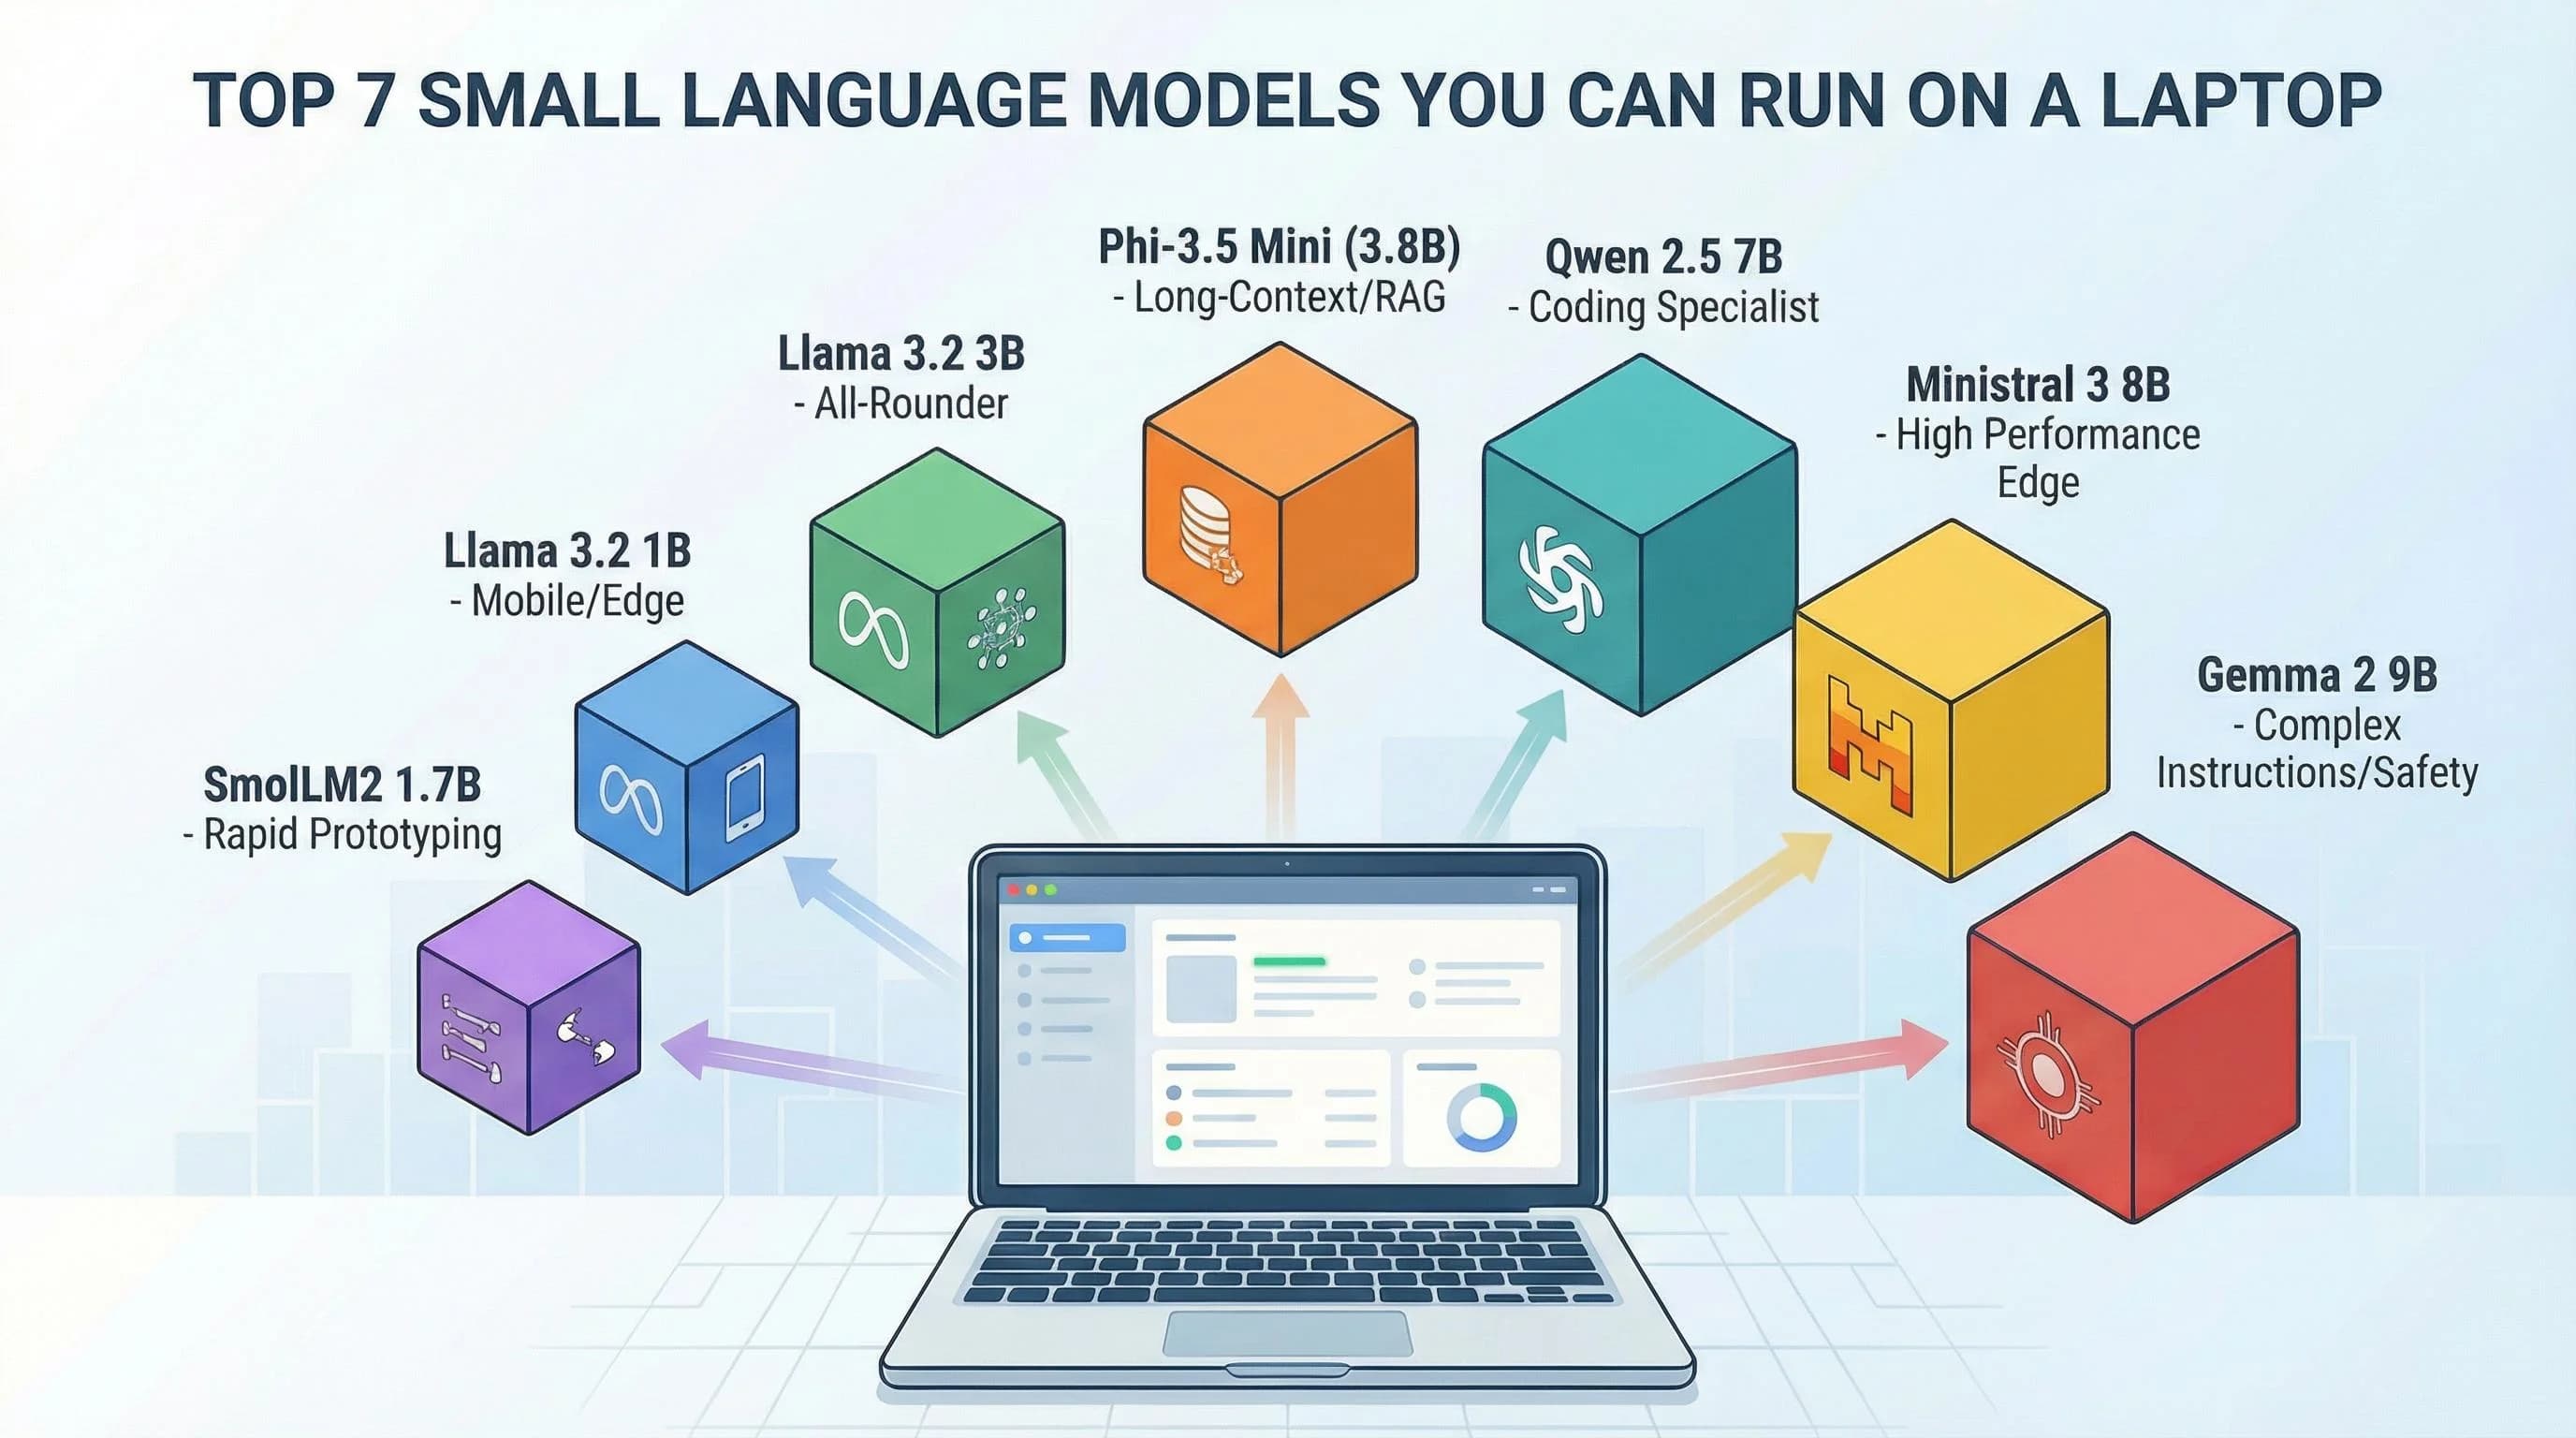
برای شروع اجرای محلی مدل زبانی بزرگ (LLM)، یک مدل دستورپذیر (Instruct) یا چتمحور با اندازه کوچک انتخاب کنید. مدلی که با سختافزار کامپیوتر شما سازگار باشد و زبان و وظایف موردنیازتان را پشتیبانی کند. برای نمونه، Llama 3.2 3B با کوانتیزهسازی Q4_K_M و حجم تقریبی ۲ گیگابایت و Qwen3 4B گزینههایی برای بررسی هستند. پیش از دانلود مدل، حجم دقیق فایل و قالب آن را بررسی کنید. زیرا نسخههای مختلف یک مدل ممکن است به حافظه و منابع پردازشی متفاوتی نیاز داشته باشند.
پس از نصب، مدل زبانی را با چند درخواست واقعی آزمایش کنید: یک پرسش فارسی، خلاصهسازی متن، پاسخگویی بر اساس یک سند و در صورت نیاز، تولید یا توضیح کد. سپس دقت پاسخ، سرعت تولید متن و میزان پیروی از دستورها را با هم بسنجید. برای مقایسه منصفانه مدلهای زبانی، از پرسشهای یکسان استفاده کنید و تنظیمات اجرا را تا حد ممکن ثابت نگه دارید؛ در غیر این صورت، نتایج آزمایشها قابل مقایسه نخواهند بود.
پس از نصب، مدل زبانی را با چند درخواست واقعی آزمایش کنید: یک پرسش فارسی، خلاصهسازی متن، پاسخگویی بر اساس یک سند و در صورت نیاز، تولید یا توضیح کد. سپس دقت پاسخ، سرعت تولید متن و میزان پیروی از دستورها را با هم بسنجید. برای مقایسه منصفانه مدلهای زبانی، از پرسشهای یکسان استفاده کنید و تنظیمات اجرا را تا حد ممکن ثابت نگه دارید؛ در غیر این صورت، نتایج آزمایشها قابل مقایسه نخواهند بود.
بهترین مدل زبانی برای زبان فارسی، برنامهنویسی و تحلیل اسناد کدام است؟
برای فارسی، مدل چندزبانهای انتخاب کنید که توانایی آن در فارسی با آزمایش عملی تأیید شده باشد. طبق بنچمارک MELAC (ACL Anthology، ۴۱ مدل)، Qwen 2.5 32B حدود ۷۱.۵، Llama 3 70B حدود ۶۵.۲ و Llama 3.1 8B حدود ۴۲.۵ امتیاز گرفتهاند. این اعداد رتبهبندی قطعی نیستند.
برای برنامهنویسی، مدلی انتخاب کنید که در تولید و توضیح کد خوب باشد و زبان شما را پشتیبانی کند. Qwen3 برای کدنویسی ارزیابی شده، اما نسخه کوچکتر را بدون آزمایش معادل نسخه بزرگتر ندانید.
برای تحلیل اسناد، مدلی با پنجره زمینه کافی و عملکرد قابلقبول در استخراج و خلاصهسازی انتخاب کنید. پنجره بزرگتر تضمین دقت نیست؛ اگر سند طولانی است، آن را به بخشهای کوچکتر تقسیم کنید.
آموزش اجرای مدل زبانی روی کامپیوتر با Ollama
Ollama ابزاری برای دانلود و اجرای مدلهای زبانی بزرگ (LLM) روی کامپیوتر شخصی است. با استفاده از آن میتوانید بدون نیاز به پیادهسازی مدل از ابتدا، یک مدل سازگار را روی ویندوز اجرا کنید و از طریق ترمینال یا محیط گرافیکی با آن گفتوگو کنید.
پیشنیازهای نصب Ollama در ویندوز
پیش از نصب Ollama، مطمئن شوید سیستم شما شرایط لازم را دارد:
- - سیستمعامل: ویندوز ۱۰ نسخه 22H2 یا جدیدتر.
- - کارت گرافیک NVIDIA: درایور نسخه 551.61 یا جدیدتر برای پشتیبانی مستندشده در راهنمای فعلی Ollama.
- - کارت گرافیک AMD: درایور سازگار با ROCm v7 یا مسیر جایگزین Vulkan، بسته به سختافزار.
- - فضای ذخیرهسازی: حداقل ۴ گیگابایت برای فایلهای برنامه؛ مدلهای زبانی به فضای جداگانه نیاز دارند و ممکن است دهها تا صدها گیگابایت اشغال کنند.
برای ویندوز، نصب معمول به دسترسی Administrator نیاز ندارد و برنامه بهطور پیشفرض در پوشه کاربر نصب میشود. Ollama نیز بهصورت بومی در ویندوز اجرا میشود و برای استفاده معمول، نصب جداگانه WSL ضروری نیست.
نصب Ollama در ویندوز و راهاندازی اولیه
برای نصب، به صفحه رسمی دانلود Ollama بروید، فایل نصب را دریافت کنید و اجرا کنید. پس از نصب، برنامه در پسزمینه اجرا میشود و دستور ollama در ترمینال در دسترس قرار میگیرد.
برای بررسی نصب، Command Prompt یا PowerShell را باز کنید و دستور زیر را وارد کنید:
ollama --versionاگر شماره نسخه نمایش داده شد، فرمان Ollama در ترمینال قابل دسترسی است. اگر ویندوز فرمان را نشناخت، مطمئن شوید نصب کامل شده و سپس یک پنجره ترمینال جدید باز کنید.
دانلود، اجرای مدل و گفتوگو با Ollama
پس از نصب Ollama، دستور زیر را در PowerShell یا Command Prompt اجرا کنید تا مدل موردنظر دانلود و اجرا شود:
ollama run gemma4با اجرای دستور، محیط گفتوگوی تعاملی در ترمینال باز میشود و میتوانید پرسشهای خود را مستقیماً وارد کنید. برای مشاهده مدلهای موجود و دستور اجرای آنها، به کتابخانه رسمی Ollama مراجعه کنید.
برای ارسال متن چندخطی، متن را داخل سه علامت نقلقول (""") قرار دهید. برای پایان دادن به گفتوگو، دستور زیر را وارد کنید:
/byeبرای اجرای مدل دیگری، ابتدا از محیط گفتوگو خارج شوید و سپس دستور ollama run را با نام مدل جدید اجرا کنید.
Ollama از مدلهای چندوجهی نیز پشتیبانی میکند. برای مثال، با مدل سازگار میتوانید مسیر یک تصویر را به دستور اجرا اضافه کنید و از مدل بخواهید محتوای آن را توصیف کند. روش دقیق استفاده به قابلیتهای مدل انتخابی بستگی دارد.
جمعبندی؛ انتخاب مدل و سختافزار مناسب برای اجرای LLM
برای اجرای مدل زبانی بزرگ (LLM) روی کامپیوتر شخصی، ابتدا کاربرد موردنظرتان را مشخص کنید. سپس بر اساس اندازه مدل، نوع کوانتیزهسازی و ظرفیت RAM و VRAM سیستم تصمیم بگیرید. مدلهای کوچکتر معمولا برای شروع و کارهای روزمره مناسبترند، درحالیکه مدلهای بزرگتر ممکن است در بعضی وظایف پیچیدهتر عملکرد بهتری داشته باشند، اما به حافظه و توان پردازشی بیشتری نیاز دارند.
پیش از انتخاب نهایی، سازگاری مدل با سختافزار و ابزار اجرایی مانند Ollama را بررسی کنید. سپس مدل را با درخواستهای واقعی خود، از جمله پرسشوپاسخ فارسی، خلاصهسازی متن یا تولید کد، آزمایش کنید. بهترین مدل برای شما لزوما بزرگترین مدل نیست؛ بلکه مدلی است که با منابع کامپیوترتان سازگار باشد و کیفیت، سرعت و مصرف حافظه مطلوبی برای کارهای موردنیازتان ارائه دهد.
۱. برای اجرای مدل زبانی روی کامپیوتر چند گیگابایت RAM لازم است؟
برای اجرای مدل زبانی روی کامپیوتر، ۸ گیگابایت RAM برای مدلهای کوچک، ۱۶ گیگابایت برای استفاده معمولی و ۳۲ گیگابایت یا بیشتر برای مدلهای بزرگتر پیشنهاد میشود. نیاز دقیق به اندازه مدل و طول متن ورودی بستگی دارد.
۲. آیا اجرای مدل زبانی روی کامپیوتر بدون کارت گرافیک امکانپذیر است؟
بله، اجرای مدل زبانی روی کامپیوتر بدون کارت گرافیک مجزا امکانپذیر است. ابزارهایی مانند Ollama مدلهای سازگار را با CPU و RAM اجرا میکنند؛ اما معمولاً سرعت کمتری دارند. برای شروع، مدلهای کوچکتر انتخاب مناسبتری هستند.
۳. بهترین مدل زبانی برای اجرا روی کامپیوتر شخصی کدام است؟
بهترین مدل زبانی برای اجرای محلی به سختافزار و نوع کاربرد بستگی دارد. برای انتخاب مدل مناسب، ظرفیت RAM و VRAM، کیفیت پاسخگویی فارسی، برنامهنویسی یا خلاصهسازی اسناد را در نظر بگیرید و عملکرد مدل را روی نیاز واقعی خود بسنجید.
۴. آیا مدل زبانی پس از دانلود بدون اینترنت هم کار میکند؟
بله، اجرای مدل زبانی بدون اینترنت امکانپذیر است. پس از دانلود مدل، ابزارهایی مانند Ollama میتوانند آن را بهصورت محلی اجرا کنند؛ اما دانلود اولیه مدل و دریافت بهروزرسانیها به اینترنت نیاز دارد.


اولین دیدگاه مفید درباره این مطلب را شما بنویسید.